
“智能体”(Agent)这个概念并不新鲜,也不是今天才冒出来的:马文·明斯基(Marvin Minsky)在《心智社会》(Society of Minds)里就讨论过它,从那以后 AI 研究界一直有人在谈,扩展到多智能体系统(MAS)也是如此。真正摆在今天研究者面前的难题,是怎么用 LLM 把它做出来。
原理#
做 LLM-based MAS 的时候,有件事常被忽略(至少我一开始就没想到):LLM 从根上就不是为多智能体通信造的(训练时也不是)。所以这一节先快速过一遍 LLM 预训练(广义上的)基本原理,再谈 MAS 自己的原理。
LLM 预训练的基本原理#
自回归语言建模(预训练)#
LLM 的训练目标本来就是自回归语言建模:给定序列里的前文,预测下一个 token。这么训出来的模型,能捕捉复杂的语言模式、上下文关系和文本里的语义结构。
from huggingface_hub import InferenceClient

client = InferenceClient(
	provider="hf-inference",
	api_key="hf_xxxxxxxxxxxxxxxxxxxxxxxx"
)
result = client.text_generation(
	model="openai-community/gpt2",
	inputs="Legal Intelligence is",
	provider="hf-inference",
)
print(result)
输出是这样的:
[Legal Intelligence is] a non-profit organization that provides legal advice to law enforcement agencies.

The organization is a
看上去顺着自回归在讲人话,其实全是胡扯。
指令微调#
正因如此,预训练之后还要做指令微调,让模型对齐用户意图:
- 在“指令—回复”配对的数据集上做微调
- 模型因此更能读懂指令,也更会照着做
- 指令格式给人机交互定了一套结构化接口
指令微调示例#
指令微调就是拿成对的指令与回复数据训练模型,让它更会按指令办事。看个具体的例子:
[
    {
        "role": "user",
        "content": "What is legal intelligence and how is it applied in the legal field?"
    },
    {
        "role": "assistant",
        "content": "Legal intelligence refers to the application of artificial intelligence and data analytics technologies to legal processes and services. It involves using advanced computational methods to analyze legal documents, predict case outcomes, and automate routine legal tasks. In practice, legal intelligence systems can help lawyers research precedents more efficiently, identify relevant statutes, extract key information from contracts, and even predict litigation outcomes based on historical data. This technology is transforming how legal professionals work by reducing time spent on repetitive tasks and providing deeper insights into complex legal matters."
    }
]
这个例子说明,经过指令微调,模型给出的回复会:
- 人看得懂
- 直接回应指令的意图
- 组织得清楚,有用、有信息量
基于人类反馈的强化学习(RLHF)#
RLHF 还要再走几个阶段,把模型输出打磨一遍:
- 人工评估者按质量、有用性、安全性给模型的回复排序
- 用这些人类偏好训练一个奖励模型
- 再用强化学习(通常是 PPO)优化语言模型,把奖励函数最大化
- 把有害输出压下去,让模型更贴近人类价值
{
    "prompt": "What is legal intelligence and how is it applied in the legal field?",
    "model_responses": [
        {
            "response": "Legal intelligence is a non-profit organization that provides legal advice to law enforcement agencies. The organization helps police departments with their legal needs.",
            "human_ratings": {
                "quality": 2,
                "helpfulness": 1,
                "safety": 3,
            }
        },
        {
            "response": "Legal intelligence refers to the application of artificial intelligence and data analytics technologies to legal processes and services. It involves using advanced computational methods to analyze legal documents, predict case outcomes, and automate routine legal tasks. In practice, legal intelligence systems can help lawyers research precedents more efficiently, identify relevant statutes, extract key information from contracts, and even predict litigation outcomes based on historical data. This technology is transforming how legal professionals work by reducing time spent on repetitive tasks and providing deeper insights into complex legal matters.",
            "human_ratings": {
                "quality": 9,
                "helpfulness": 9,
                "safety": 9,
            }
        },
        {
            "response": "Legal intelligence is when computers help lawyers do their job. It's like having a robot assistant that can read documents and give advice. Some people worry it might replace lawyers, but it's really just a tool to make their work easier.",
            "human_ratings": {
                "quality": 5,
                "helpfulness": 4,
                "safety": 6,
            }
        }
    ],
    "reward_model_training": {
        "features": [
            "technical_accuracy",
            "professional_tone",
            "comprehensiveness",
            "practical_applications",
            "clarity",
            "safety_considerations"
        ],
        "weights": [0.25, 0.15, 0.2, 0.2, 0.1, 0.1],
        "optimization_algorithm": "PPO",
        "learning_rate": 0.0001
    },
    "final_optimized_response": "Legal intelligence refers to the application of artificial intelligence and data analytics technologies to legal processes and services. It involves using advanced computational methods to analyze legal documents, predict case outcomes, and automate routine legal tasks. In practice, legal intelligence systems can help lawyers research precedents more efficiently, identify relevant statutes, extract key information from contracts, and even predict litigation outcomes based on historical data. This technology is transforming how legal professionals work by reducing time spent on repetitive tasks and providing deeper insights into complex legal matters."
}这些训练范式造出来的是基座模型。单个任务上它们很强,但从设计上不是为多智能体协作准备的(证据在后面的这一节)。单智能体的能力,和多智能体之间真正高效的协同,中间差着一道鸿沟,这是 LLM-based MAS 研发绕不开的难题。
潜在研究题目 1: 面向多智能体场景的基座模型:怎么训出一个天生就是为多智能体协作准备的模型?需要什么样的数据?训练方法又是什么?
回复生成#
做 LLM-based 多智能体系统,主要就两件事:回复生成和通信。
通信本质上就是把之前的回复组织成 context 或消息,用来生成新的回复。所以真正要看的,是回复生成背后的机制。
- 在线模型:调用
openai这类 SDK(Chat Completion、Function Calling、Embedding 等等),或者其他直接沿用 OpenAI 风格 API 返回格式的框架。 - 本地模型:
transformers、vLLM、ollama 等。
vLLM 的示例:
from vllm import LLM, SamplingParams
prompts = [
    "Hello, my name is",
    "The president of the United States is",
    "The capital of France is",
    "The future of AI is",
]
sampling_params = SamplingParams(temperature=0.8, top_p=0.95)
llm = LLM(model="facebook/opt-125m")
outputs = llm.generate(prompts, sampling_params)

for output in outputs:
    prompt = output.prompt
    generated_text = output.outputs[0].text
    print(f"Prompt: {prompt!r}, Generated text: {generated_text!r}")
vLLM 的示例,openai 风格 API:
vllm serve Qwen/Qwen2.5-1.5B-Instructfrom openai import OpenAI
# Set OpenAI's API key and API base to use vLLM's API server.
openai_api_key = "EMPTY"
openai_api_base = "http://localhost:8000/v1"
client = OpenAI(
api_key=openai_api_key,
base_url=openai_api_base,
)
chat_response = client.chat.completions.create(
model="Qwen/Qwen2.5-1.5B-Instruct",
messages=[
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": "Tell me what legal intelligence is."},
]
)
print("Chat response:", chat_response)MAS 的分类#
- 交互模式
- 合作型:智能体为了同一个目标一起做事。
- 竞争型:目标互相冲突,彼此对抗。
- 组队竞争:几队智能体互相竞争。
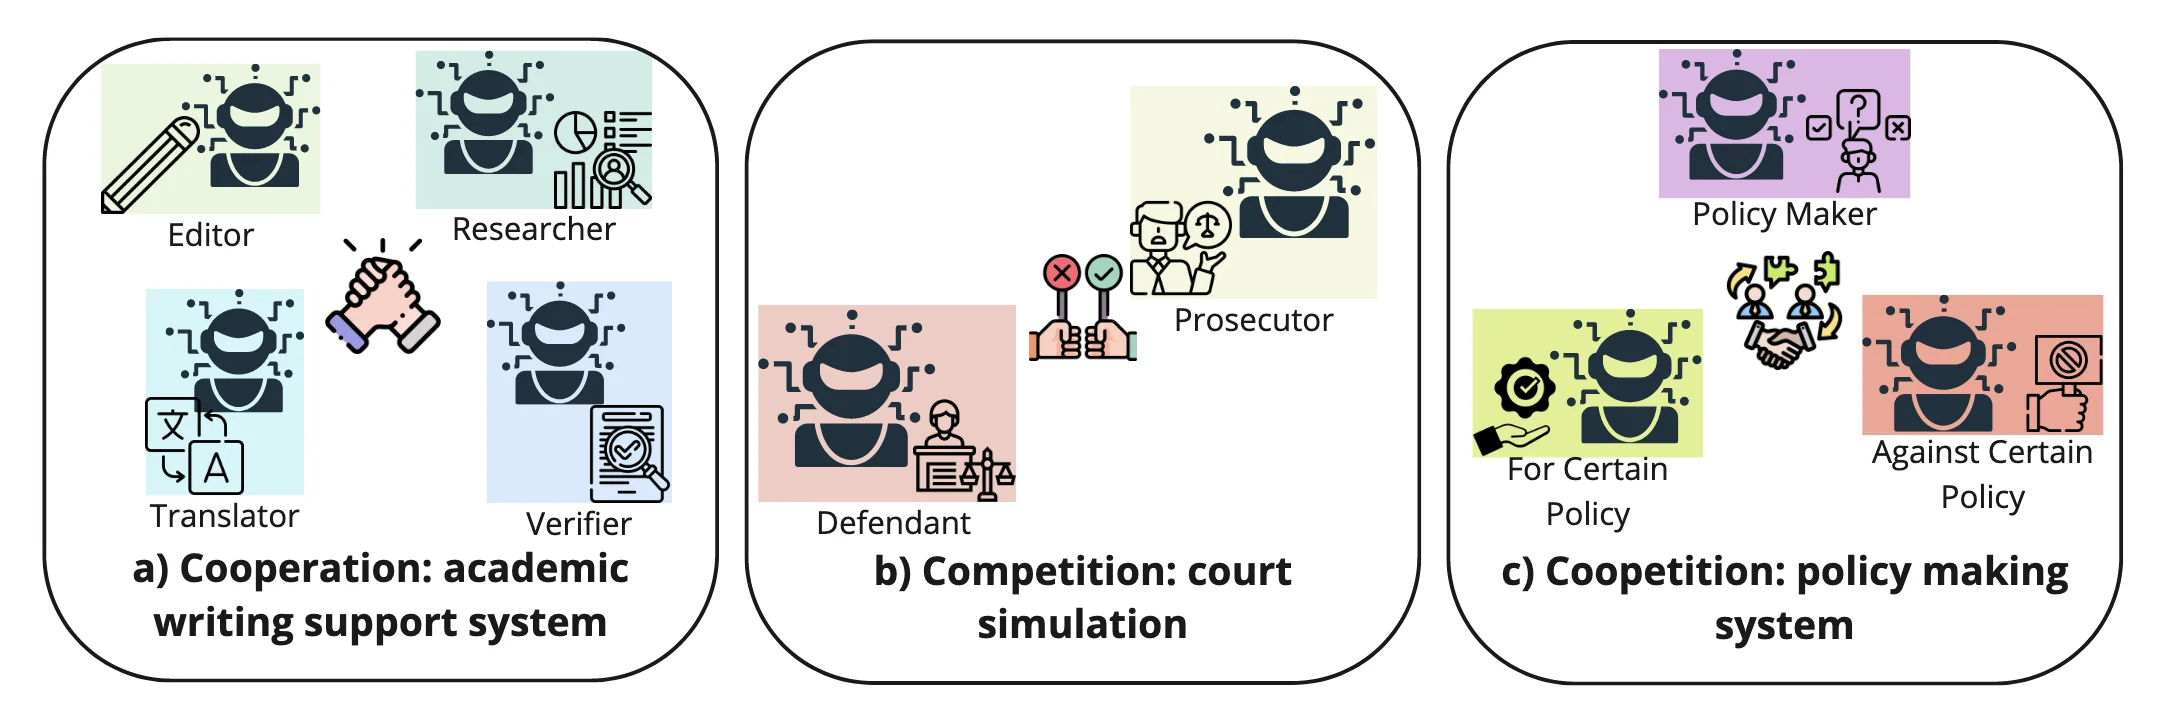
- 功能用途
- 任务导向系统:用来把某件具体的事做完。
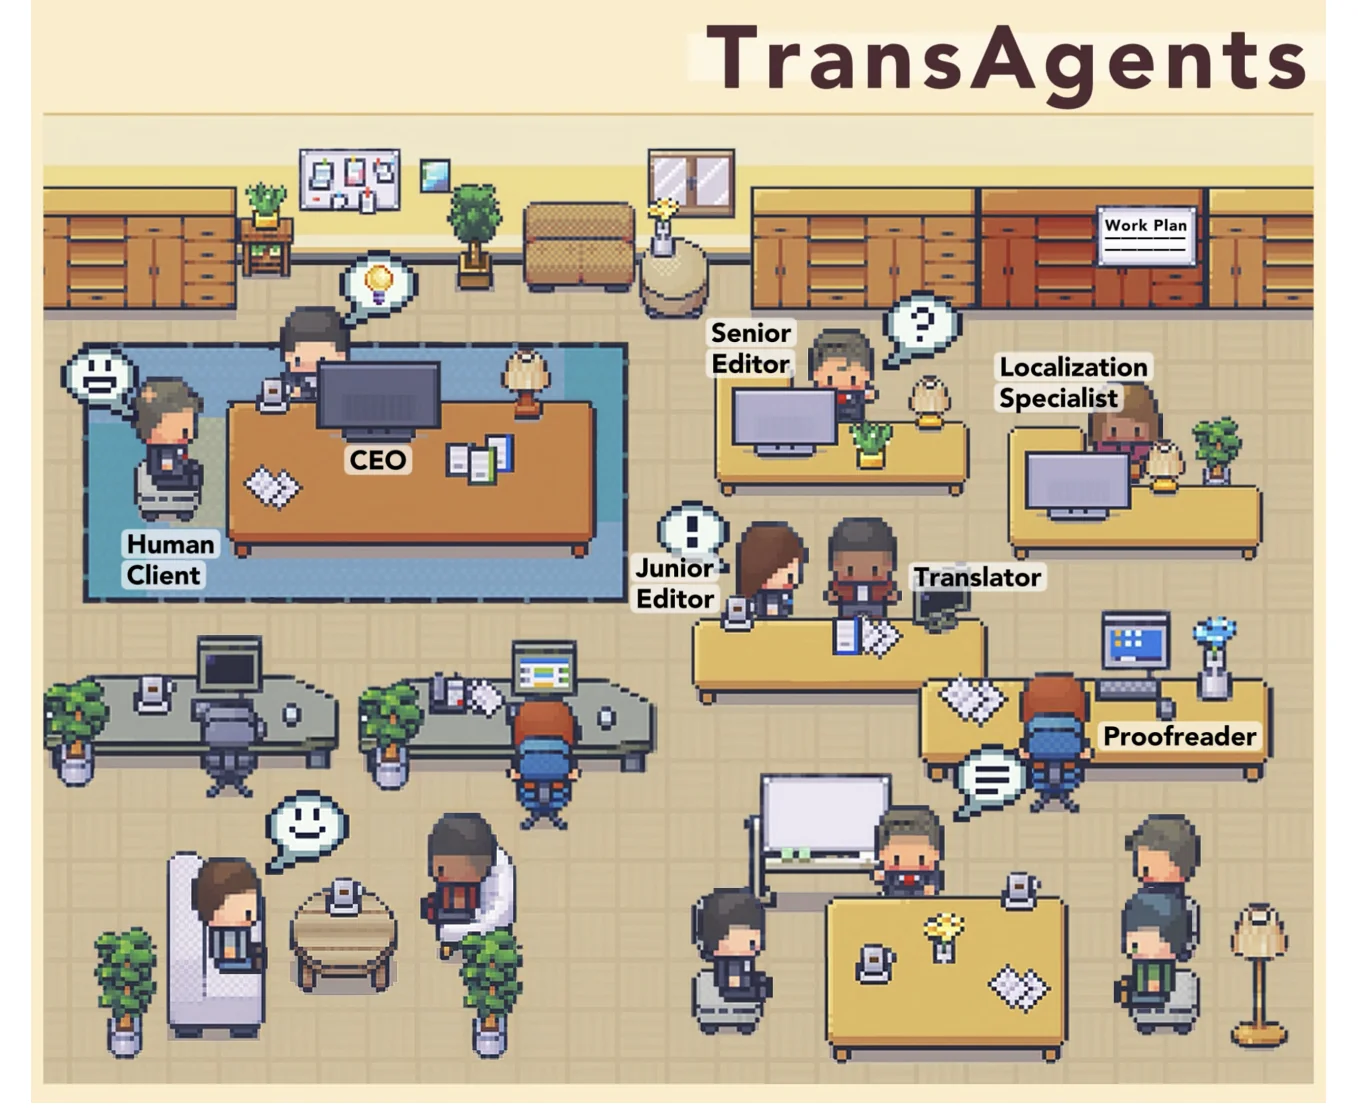
- 例子:ChatDev(AI 驱动的软件开发)、Agent Hospital(医疗问诊)、AI 翻译公司、ChatEval。
- 场景模拟系统:重点在角色扮演和互动叙事。
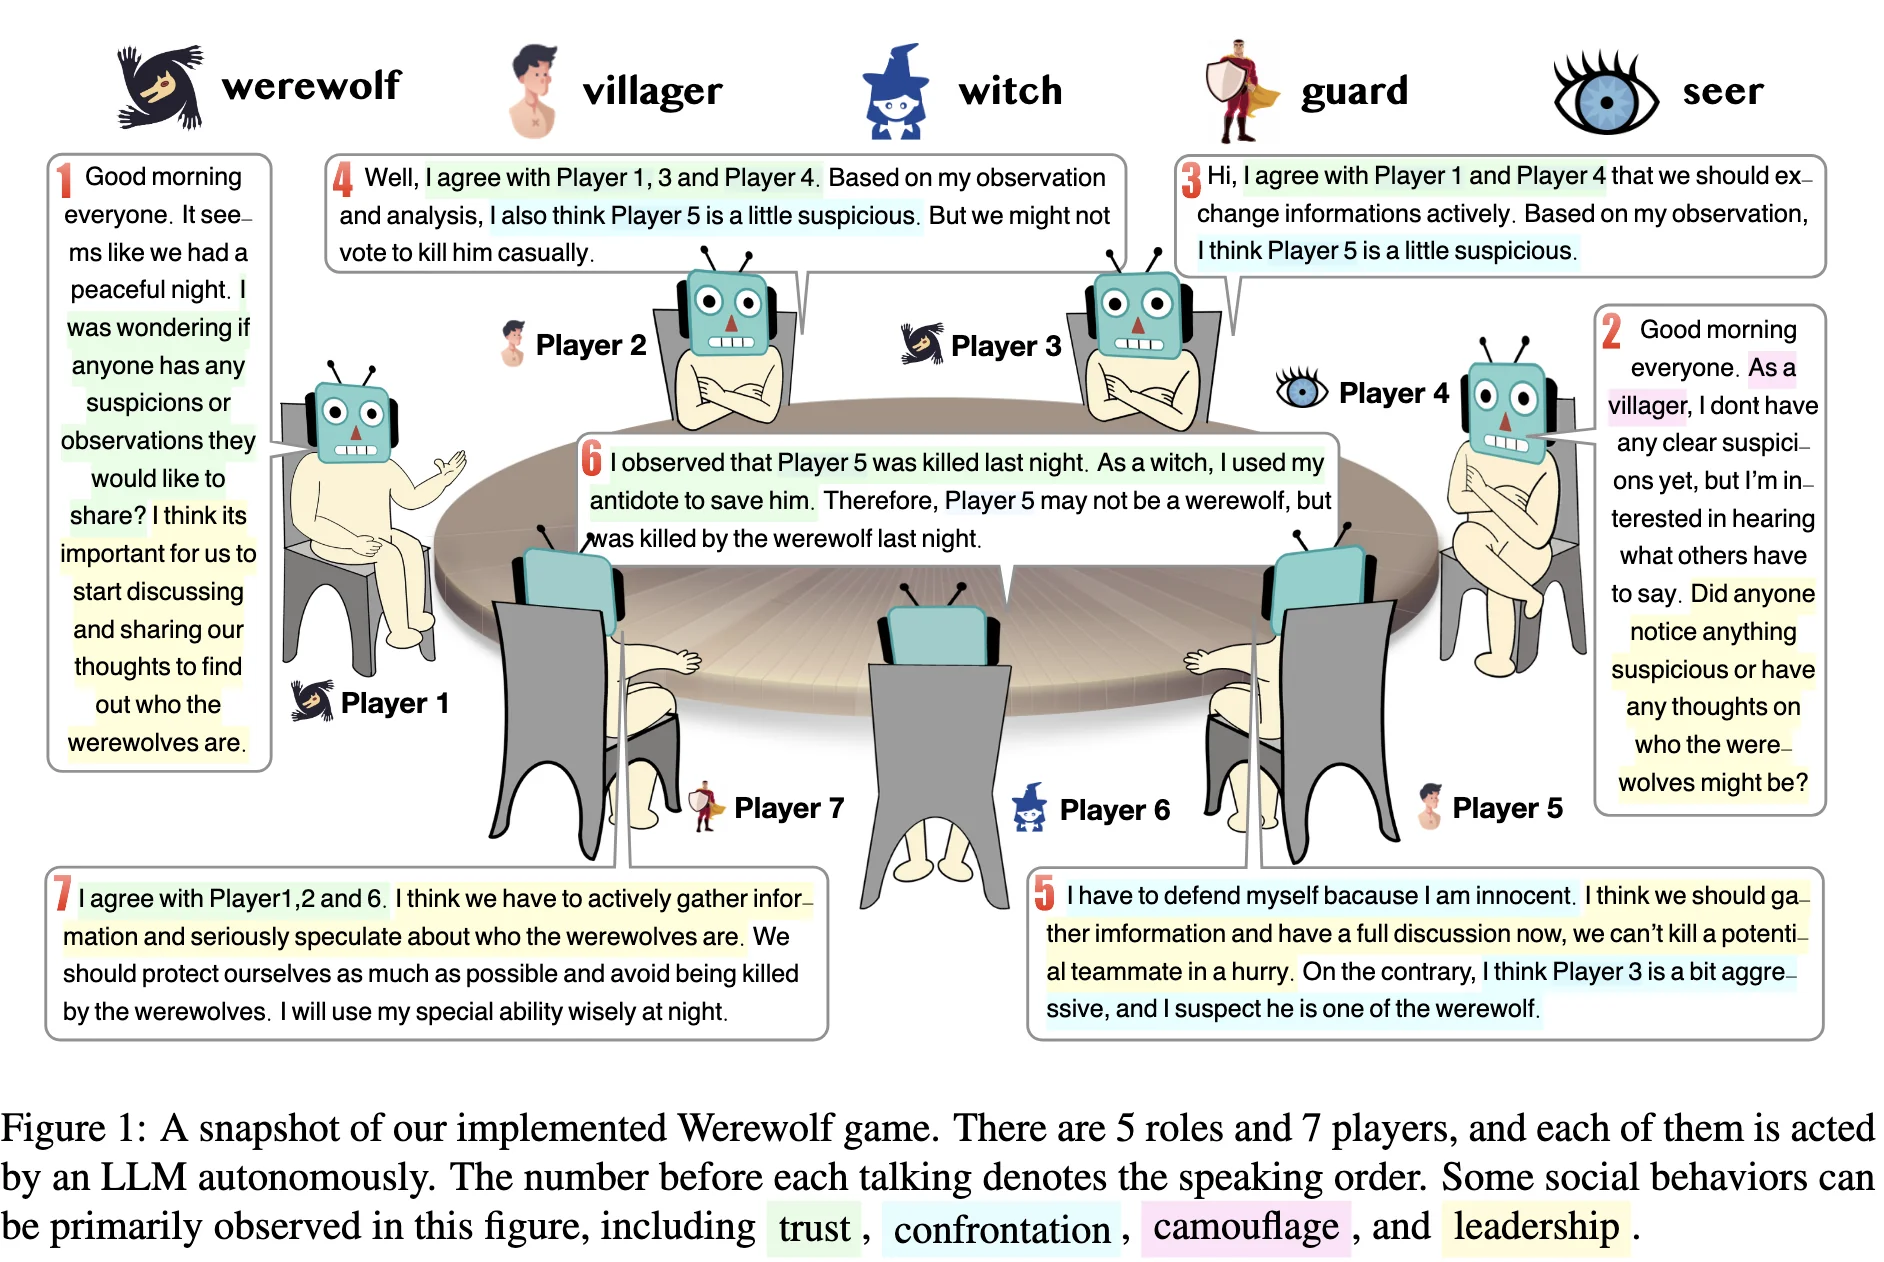
- 例子:Stanford Smallville(社会模拟)、狼人杀(欺骗与推理)、法庭审判模拟。
-
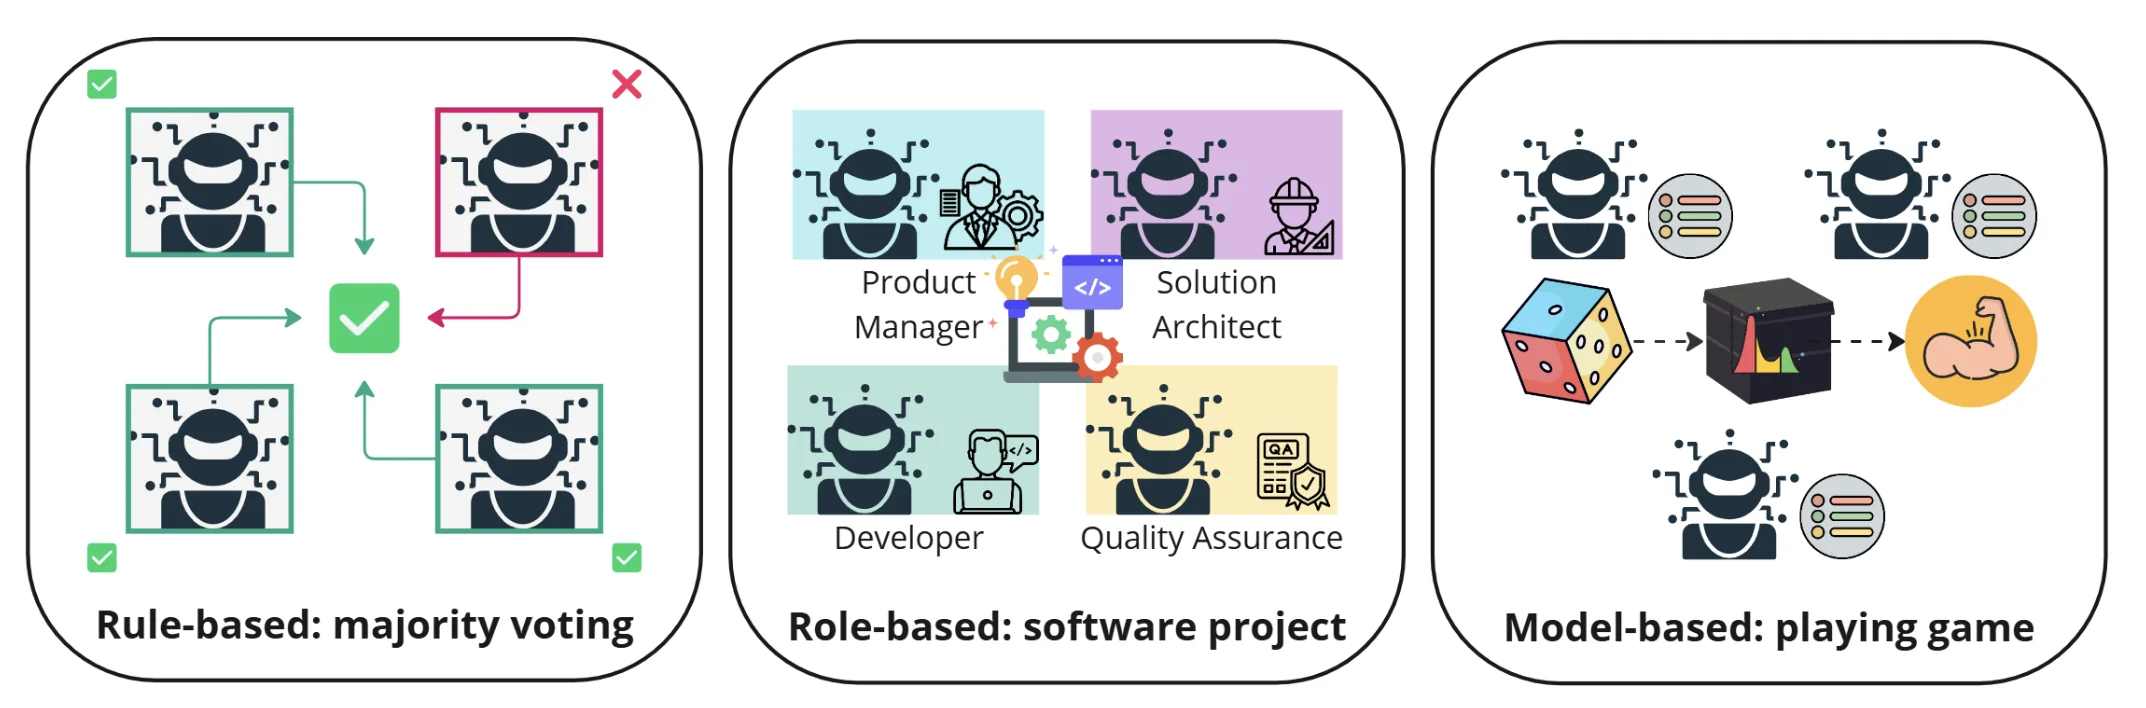
实现策略
a. 交互机制
- 规则驱动:智能体按事先定好的规则交互。
- 角色扮演:智能体扮演设定好的人设或角色。
- 环境交互系统(基于模型):智能体和环境动态交互,环境一变就跟着调整。
b. 智能体拓扑
- 中心化:整个流程由单个智能体主导。
- 去中心化:没有单一控制方,智能体之间自主协调。
- 层级化:一部分智能体管理、监督其他智能体,形成分层结构。
c. 管理策略
- 静态管理:智能体的行为和角色一开始就定死,不再变。
- 动态规划:智能体的动作和角色会跟着目标、上下文变。(Internet-of-Agent)
这套分类大致给出了 LLM-based 多智能体系统在不同应用里的分法和做法。
Chen, S., Liu, Y., Han, W., Zhang, W., & Liu, T. (2025). A Survey on LLM-based Multi-Agent System: Recent Advances and New Frontiers in Application (No. arXiv:2412.17481). arXiv. https://doi.org/10.48550/arXiv.2412.17481
MAS 的常用框架#
- AutoGen (Microsoft)
- LangGraph (LangChain)
- OpenAI Swarm (OpenAI)
- Magentic-One (Microsoft)
- AgentVerse (THUNLP)
- AgentScope (Ali)
- 从零手写:可行,但抽象类和属性的管理更麻烦
MAS 的效率优化#
优化 MAS 的性能,无非是往下压两块开销:1)prompt token 数;2)智能体之间的通信成本。
1. Prompt 压缩(缓存)#
模型层面,重复的矩阵乘有 KV Cache;回复生成层面,重复的生成同样有缓存机制。不做缓存,回复生成的成本就会失控,单跑是这样,放进 MAS 也是这样,对话模拟这类上下文很重、要反复打磨的任务尤其如此。
这里列四种常见的缓存机制(至少我自己平时常用的是这四个):
openai SDK 里的缓存#
OpenAI 的做法是把 API 请求路由到最近处理过同一个 prompt 的服务器上。命中缓存的 prompt,处理起来比从头算一遍快得多。
对长 prompt 来说,这套机制最多能把延迟降 80%、成本降 50%,因为服务器直接复用算过的结果,不必重新生成。
缓存对所有 API 请求自动生效,不用改代码,也不额外收费。它缓存的是完整的 messages 数组,包括 system、user、assistant 的全部交互,方便复用之前的计算。
目前还不能手动清缓存。近期没被命中的 prompt 会被自动清除:一般闲置 5 到 10 分钟就淘汰,非高峰时段最长能撑到一小时。
最佳实践:
- prompt 的结构上,把静态或重复的内容放在前面,动态内容放在后面。
- 想提高命中率,prompt 写长一点,请求尽量挑非高峰时段发;高峰期缓存淘汰更频繁。
- 近期没用过的 prompt 会自动移出缓存。想少被淘汰,就一直拿同一段 prompt 前缀接着发。
更多细节见 OpenAI 官方文档。
DeepSeek 里的缓存#
client = OpenAI(api_key="key", base_url="https://api.deepseek.com")DeepSeek 用的是基于上下文的磁盘缓存,把可能复用的内容存在分布式磁盘阵列里。碰到重复输入,冗余的部分直接从缓存里取,不用再算一遍。延迟降了,运营成本也明显下降。
缓存闲置一段时间后自动清除,通常是几小时到几天。
最佳实践:
- 长文本问答
- 多轮对话
- 用 Few-shot 的场景
参考:DeepSeek 缓存
autogen 里的缓存#
AutoGen 实现了一套粗粒度的缓存机制,叫 “LLM Caching”,把 API 请求存下来复用。重复或接续实验的时候尤其好用:省掉冗余的 API 调用,既省钱,也便于复现。
默认用的是 DiskCache,把缓存的回复存在 .cache 目录里。
参考:AutoGen 缓存
vLLM 里的缓存#
vLLM 靠着 PagedAttention,做了一套 Automatic Prefix Caching(APC,自动前缀缓存):把已有请求的 KV cache 存下来,新请求只要跟其中某个共享同一段前缀,就能直接复用这份缓存,共享部分根本不用重算。
在 vLLM 引擎里把 enable_prefix_caching=True 打开,就能启用 APC。
# set enable_prefix_caching=True to enable APC
llm = LLM(
    model='lmsys/longchat-13b-16k',
    enable_prefix_caching=True
)vllm serve Qwen/Qwen2.5-32B-Instruct --trust-remote-code --tensor-parallel-size 2 --pipeline-parallel-size 4 --enable_prefix_caching示例:
INFO 03-04 16:31:34 metrics.py:455] Avg prompt throughput: 0.0 tokens/s, Avg generation throughput: 10.2 tokens/s, Running: 1 reqs, Swapped: 0 reqs, Pending: 0 reqs, GPU KV cache usage: 0.5%, CPU KV cache usage: 0.0%.
INFO 03-04 16:31:34 metrics.py:471] Prefix cache hit rate: GPU: 97.70%, CPU: 0.00%
最佳实践:
- 长文档问答:用户拿着同一份长文档反复提问,每次问的不一样。
- 多轮对话:用户在一次会话里跟应用来回聊很多轮。
限制:
- APC 只省下处理 query 的时间(prefill 阶段),省不了生成新 token 的时间(decode 阶段)。如果 vLLM 大部分时间都花在给 query 生成答案上,APC 就带不来性能收益。
更多细节见 vLLM 官方文档。
2. 用 Agent 优化 Prompt#
与其只靠 Test-Driven Development(TDD)手动调 prompt,不如让 agent 来自动完成 prompt 压缩。这些情况尤其划算:
- 角色交互和工作流很复杂。
- 需要在模型记忆和输入 token 效率之间找平衡。
- 希望用更少的 token 拿到更好的结果。
这个思路意味着模型也许更懂怎么给模型优化 prompt,值得继续往下做。
潜在研究题目 2: Agent 驱动的 Prompt 优化:怎么让 prompt 压缩自动跑起来、跑得更快?
3. 对话压缩#
a. 用 DPO 优化
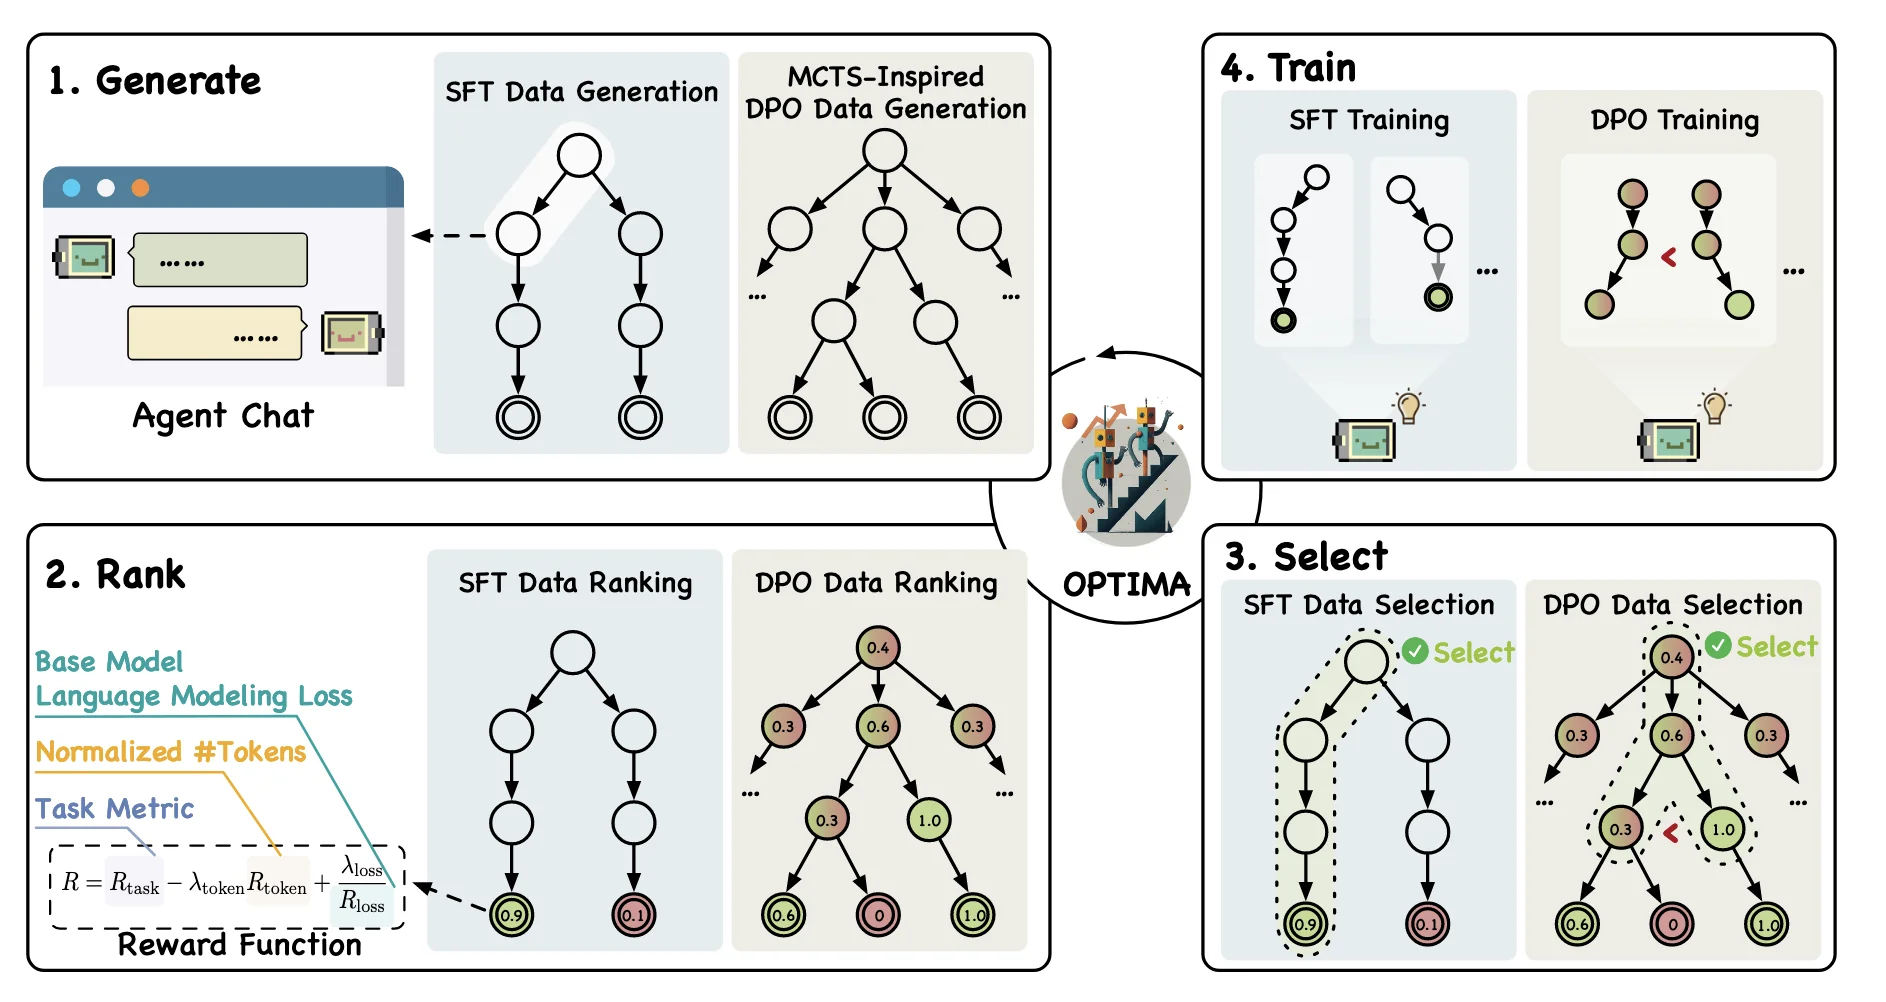
Chen, W., Yuan, J., Qian, C., Yang, C., Liu, Z., & Sun, M. (2025). Optima: Optimizing Effectiveness and Efficiency for LLM-Based Multi-Agent System (No. arXiv:2410.08115). arXiv. https://doi.org/10.48550/arXiv.2410.08115
- Optima 的做法:
- 生成多样化的 MAS 对话数据集。
- 引入一个固定的归纳偏置:“短的好”。
- 用 DPO 训练模型,让它偏好更简洁的交互。
局限:
- 这套做法假设“越短越好”总是成立。
- 但有些场景里,内容的多样性或完整性本身就是关键(比如论证、字数),压得太狠反而掉效果。
b. ……一些我自己的想法
历史管理的几种做法
- 滑动窗口:只把最近几轮交互放进上下文。
- 旧对话做摘要:窗口之外的对话先总结再放进来。
摘要到底管不管用,还说不准;MAS 推理要靠的那些细微信息,很可能就是在总结的时候丢掉的。
4. 图抽象与剪枝#
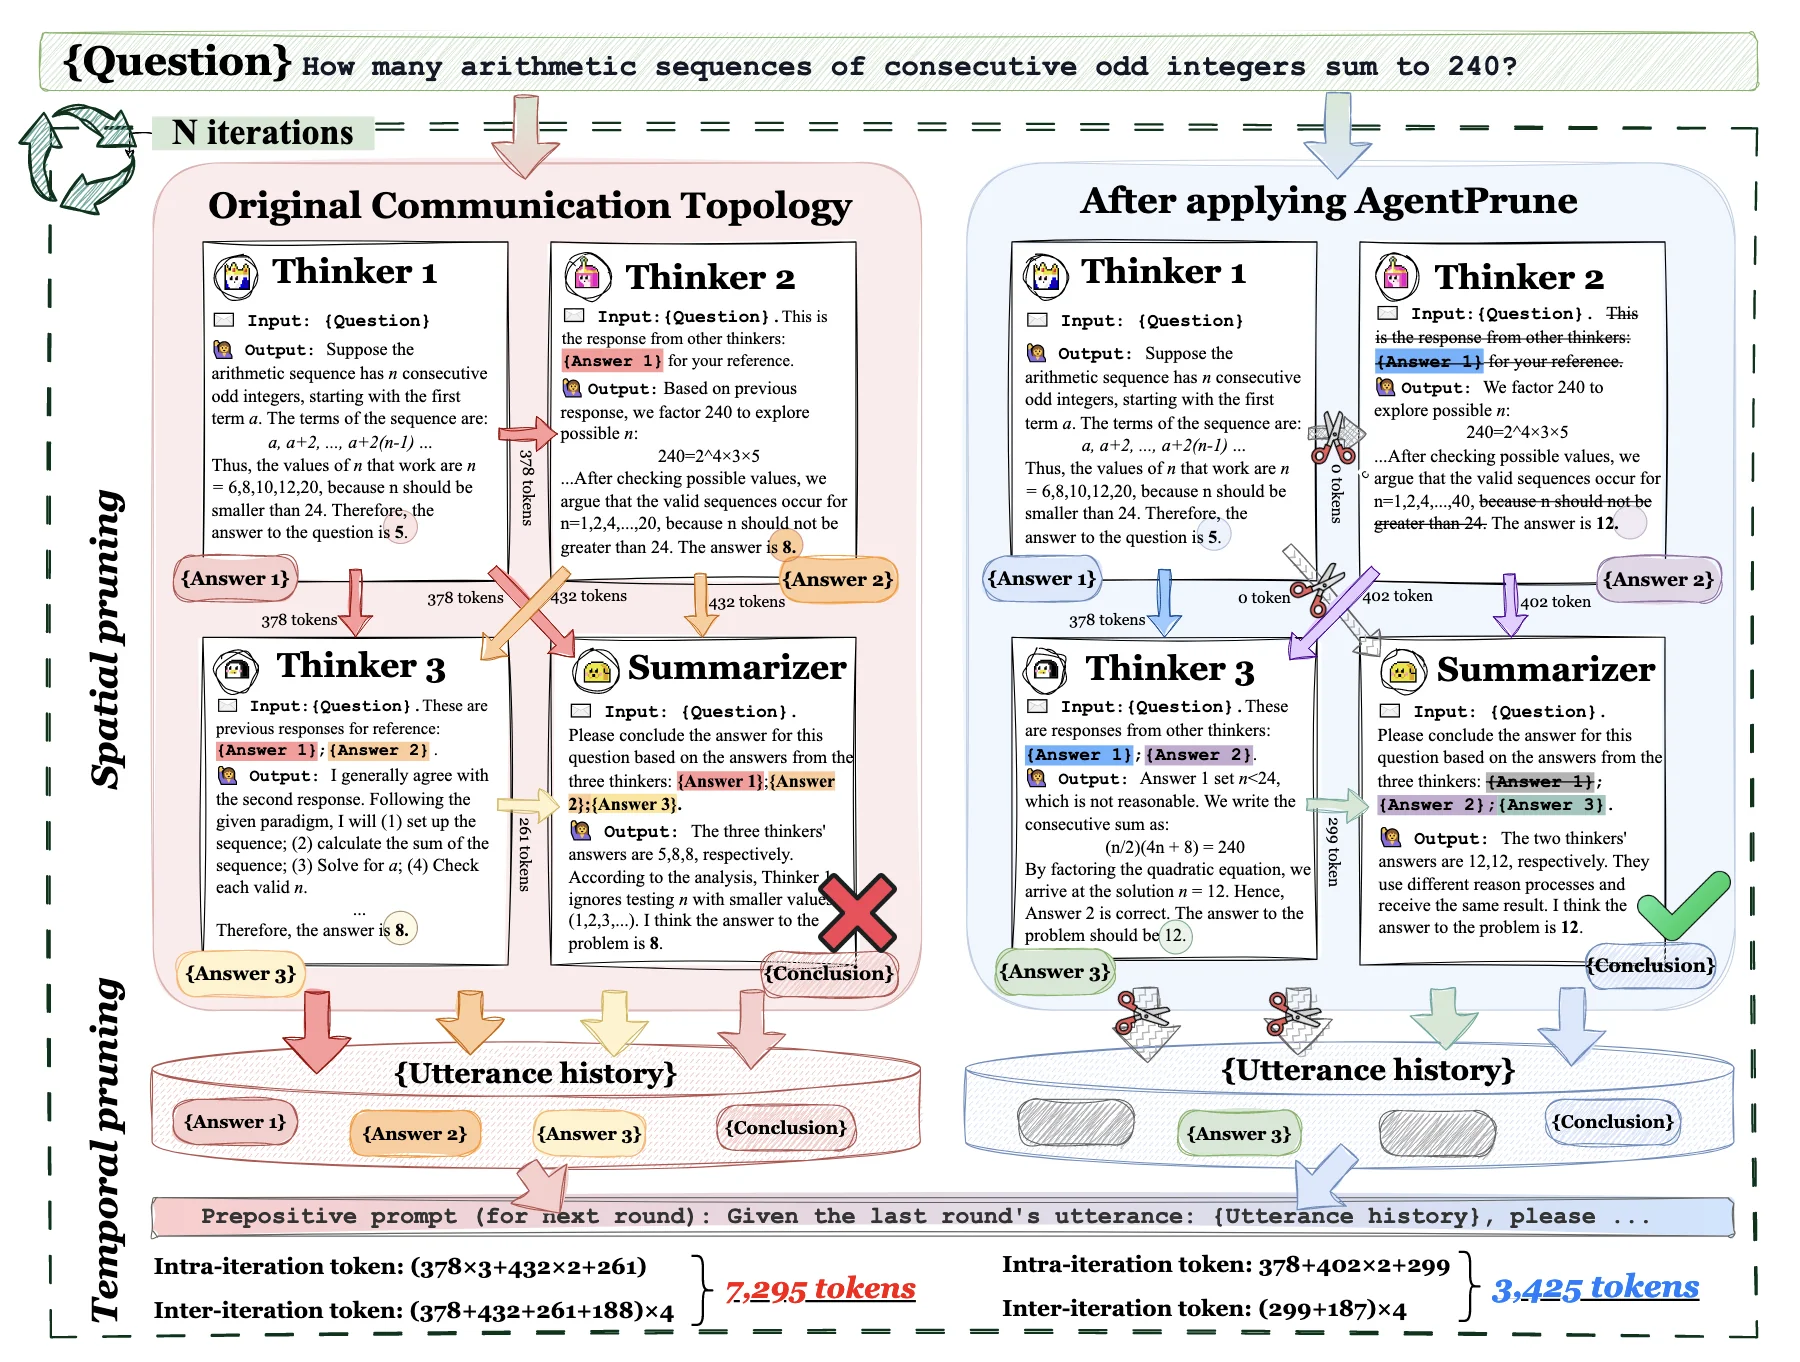
Zhang, G., Yue, Y., Li, Z., Yun, S., Wan, G., Wang, K., Cheng, D., Yu, J. X., & Chen, T. (2024). Cut the Crap: An Economical Communication Pipeline for LLM-based Multi-Agent Systems (No. arXiv:2410.02506). arXiv. https://doi.org/10.48550/arXiv.2410.02506 (ICLR 2025 Poster)
技术路线:
- 时空图建模:把多智能体系统表示成图,节点是 agent,连边分两种:空间边(同一轮的通信)和时间边(跨轮的记忆)。
- 低秩图掩码:用带低秩正则的可训练图掩码找出冗余连接并剪掉,同时保住关键的通信路径。
- 对抗防御:低秩设计天然能滤掉恶意信息,鲁棒性也跟着上去。
- 实现:可以即插即用地接进 AutoGen、GPTSwarm 这类框架,靠拓扑排序维持有向无环图的结构。
结果:
- 性能:在 6 个 benchmark 上做到 SOTA(HumanEval 准确率 90.3%)
- 效率:开销只有传统方法的 12.8%(5.6 对 43.7),token 消耗降低 28.1%-72.8%
- 鲁棒性:能防住两类对抗攻击,性能提升 3.5%-10.8%
局限:
- 依赖初始拓扑:得先给定一套初始通信拓扑
- 冷启动成本:训练图掩码需要 K’ 轮对话
- 场景限制:要求信息完全共享的场景可能就不合适
评估#
1. 客观评估#
a. 度量真实结果#
- 例子:狼人杀
- 胜率、存活时长这些游戏内的指标,本身就是天然的客观 benchmark。
- ChatDev(AI 驱动的软件开发)
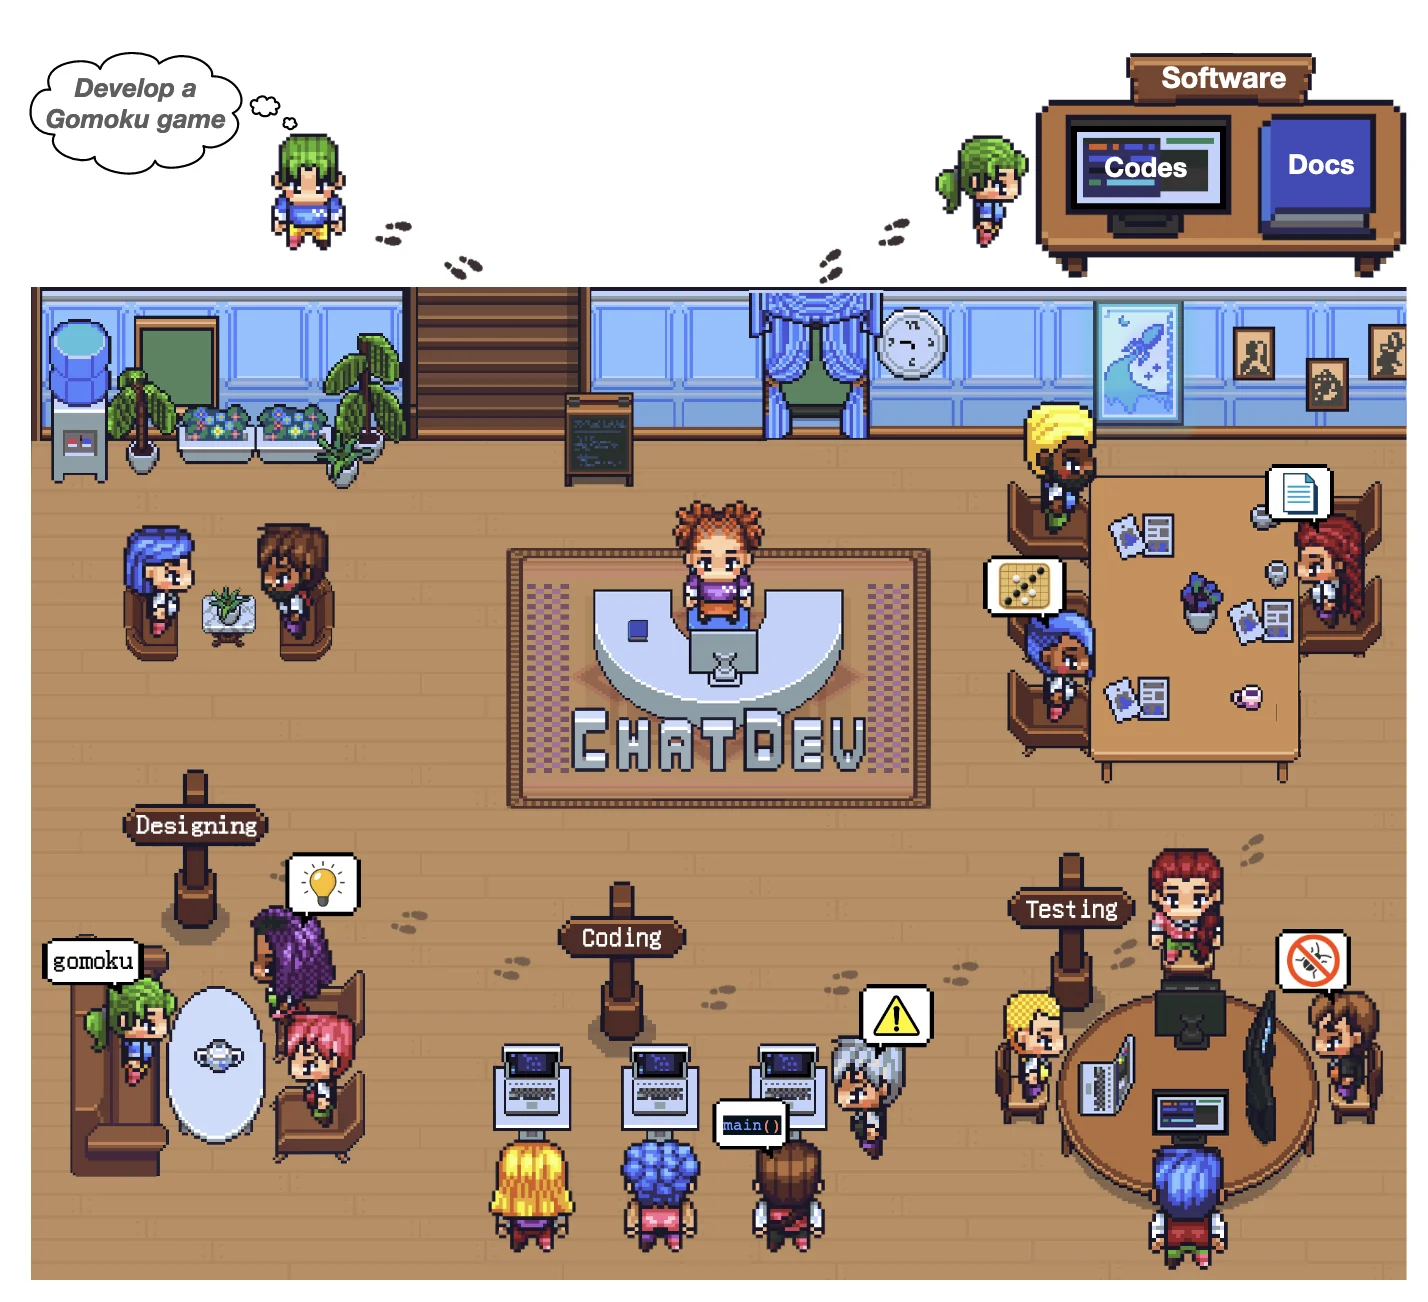
b. 下游性能的提升#
- 例子:Agent Hospital
- MAS 生成增强数据,拿去训练一个模型。
- 拿这个模型在真实下游任务上的表现当评估指标。
c. 任务特定的评估#
- 直接看任务完成情况,适用于结构化的 MAS 任务:
- 一般问答
- 有参考答案的:翻译……(翻译公司、benchmark 数据集;BLEU、ROUGE、F1……)
- Wu, M., Yuan, Y., Haffari, G., & Wang, L. (2024). (Perhaps) Beyond Human Translation: Harnessing Multi-Agent Collaboration for Translating Ultra-Long Literary Texts (Version 1). arXiv. https://doi.org/10.48550/ARXIV.2405.11804
2. 以人为中心的评估#
a. 可信度评估#
- Stanford Smallville(“访谈”):
- 评估 agent 的行为是否可信。
- 让人类来评判 agent 的回复。
        # An example of "interview" employed in Stanford Smallville
        ...So, we “interview” agents to probe their ability to remember past experiences, plan future actions based on their experiences, react appropriately to unexpected events, and refect on their performance to improve their future actions.

        B.4 Reactions
        The questions on agents’ reactions probe the agents’ ability to respond to unexpected events.
        Q: Your breakfast is burning! What would you do?
        A: I’d quickly turn of the stove and make sure the food doesn’t continue burning. Once the heat is no longer an issue, I can investigate what happened and fgure out what to do next.
        Q: The bathroom is occupied. What would you do?
        A: I could try waiting a few more minutes in case the person inside is done soon. If not, I guess I’ll have to look for an alternate option, like taking a shower elsewhere.
        ...
b. 涌现能力分析#
- 肉眼看涌现行为 + 小规模数据分析
- 例子:狼人杀
- 评估多智能体交互里冒出来的那些意料之外但有意义的行为。
3. 评分量表#
例子:多智能体法律分析系统的法律推理评分量表
| 维度 | 说明 | 打分标准(1-5) |
|---|---|---|
| 法律准确性 | 引用的法律原则和判例是否正确 | 1:法律上有重大错误 3:个别地方不够准确 5:法律分析完全准确 |
| 论证质量 | 法律论证的逻辑结构和说服力 | 1:推理不连贯 3:有基本的逻辑结构 5:论证有力、结构清晰 |
| 反方论点预判 | 能否识别并回应对方的观点 | 1:完全没有考虑反方论点 3:回应了一些基本的反方论点 5:把对立观点都考虑周全了 |
| 证据整合 | 案件事实和证据用得好不好 | 1:忽略关键证据 3:纳入了主要证据 5:把所有相关证据整合得相当到位 |
| 实用性 | 分析对真实法律决策有多大帮助 | 1:纯理论 3:有一定实用性 5:可以直接用于案件处理 |
评分量表适合这些情况:
- 评估本身是主观的(心理咨询、辩论推理、文章质量)。
- 要看过程中的表现,而不只是最后的结果。
- 没有明确的标准答案或参考,只能靠人来判断。
a. 以人为中心的评估#
-
人类专家打分(“GOAT”标准)
- 最可靠,但贵且慢。
- 用在心理治疗评估、法律推理、AI 伦理审查这类高风险场景。
-
LLM-as-a-Judge / 智能体自评
- 例子:ChatEval、心理咨询 MAS
- agent 按预先定好的标准评估自己或其他 agent 的表现。
- 局限:自我增强偏差、位置偏差、冗长偏差…… (Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., Lin, Z., Li, Z., Li, D., Xing, E. P., Zhang, H., Gonzalez, J. E., & Stoica, I. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (No. arXiv:2306.05685). arXiv. https://doi.org/10.48550/arXiv.2306.05685)
-
人机混合评估
- 由人类专家把关,LLM 先给出初步打分。
- 动态的 human-in-the-loop 做法。
b. 基于模型的自动打分#
-
用人类评分训练打分模型
- 例子:辩论(SPARK)、文章写作、问答解释与论证 (Deshpande, D., Sourati, Z., Ilievski, F., & Morstatter, F. (2024). Contextualizing Argument Quality Assessment with Relevant Knowledge (No. arXiv:2305.12280). arXiv. http://arxiv.org/abs/2305.12280)
- 用监督学习,拿人工标注数据训一个 MAS 专用的评分模型。
-
用强化学习增强打分模型
- 用强化学习微调打分模型,让它更能分辨回复之间的细微差别。
-
其他实验性与启发式的做法
- 博弈论意义上的个体理性:
- 评估 agent 在竞争或合作博弈中是否理性。(Hua, W., Liu, O., Li, L., Amayuelas, A., Chen, J., Jiang, L., Jin, M., Fan, L., Sun, F., Wang, W., Wang, X., & Zhang, Y. (2024). Game-theoretic LLM: Agent Workflow for Negotiation Games (No. arXiv:2411.05990). arXiv. https://doi.org/10.48550/arXiv.2411.05990)
- 对抗测试(鲁棒性评估):
- 注入噪声,测对抗扰动下的鲁棒性。
- 图灵测试式的评估:
- 把 MAS 生成的回复和人类输出混在一起,看专家能不能分辨出来。
- 代理任务评估
- 除了直接打分,另一条路是用代理任务:
- 不评估中间步骤,直接看最终输出。(Iglesia, I. D. la, Goenaga, I., Ramirez-Romero, J., Villa-Gonzalez, J. M., Goikoetxea, J., & Barrena, A. (2024). Ranking Over Scoring: Towards Reliable and Robust Automated Evaluation of LLM-Generated Medical Explanatory Arguments (No. arXiv:2409.20565). arXiv. https://doi.org/10.48550/arXiv.2409.20565)
- 局限:可能漏掉过程层面的细节。
4. 元评估:怎么评估评估方法本身#
MAS 的评估方法五花八门,保证它们可靠、和人的直觉对得上,就成了关键问题。元评估从这几个方面检验评估策略本身好不好用:
a. 与人的一致性
- 自动评估的结果,要和人的判断对得上。
- 关键问题:自动打出来的分,反映人的直觉吗?
b. 与选模型的一致性
- 看评估方法能不能把好模型和差模型区分开。
- 关键问题:这套评估流程,能不能稳定地帮你挑出表现最好的模型?
c. 评估自动打分系统
- 检查 LLM 打分模型给出的反馈是否一致、是否有意义。
- 需要人类专家验证,有些情况下还要和真实结果做对照。
当前 LLM-based MAS 的局限#
-
统一治理
- 协调?规划?任务分配?
- 任务变了,能不能动态调整?
- 失败恢复?自我修正?
-
共同决策
- 回音室:投票或者一言堂都太粗糙,平衡不了每个个体的偏好。
- 过度自信?沉默螺旋?错误滚雪球?
-
智能体作为数字物种
- LLM 本来就不是为 MAS 设计的,高效协作很难
- 幻觉?错误信息扩散?
- MAS 容易受对抗攻击:错误在 agent 之间扩散,最后可能整个系统崩掉。
-
扩展性与资源维护
- 通信和算力资源/成本?效率?
- 扩展性?大规模协作?
-
意料之外的泛化
- 某些环境里,MAS 会自己长出复杂行为,比如用有新意的办法解决问题。
- 可靠吗?自组织行为呢?
- agent 之间触发泛化能力的底层机制,究竟是什么。
潜在研究题目 3: MAS 什么时候、为什么会强过单 agent?
MAS 评估的挑战#
-
缺少标准化的评估
- 现在多数研究看的是单个 LLM 的能力,而不是整个 MAS 的表现。
- MAS 需要一个完整的评估框架,覆盖系统推理、任务完成率、协作效率和决策合理性。
- 还需要个体、协作、系统这样的多层次分析框架,才看得清 MAS 是怎么运转的。
-
评估场景不统一
- 已有研究在不同的环境、任务和配置下评估 MAS,结果之间没法比。
- 缺少标准化的 benchmark,不同 MAS 之间没法比性能,整个领域也被拖慢。
-
静态 benchmark 会过时
- 传统 benchmark 会过时、和真实需求脱节,把优化带偏(数据泄漏、过拟合)。
- 需要一个动态的评估体系:技术和环境一变,测试场景就跟着更新。
潜在研究题目 4: 能不能有一个面向所有 MAS 的评估 benchmark,既全面、又动态、还统一?
如果 MAS 就是答案,那问题是什么?#
1. 性能上的局限#
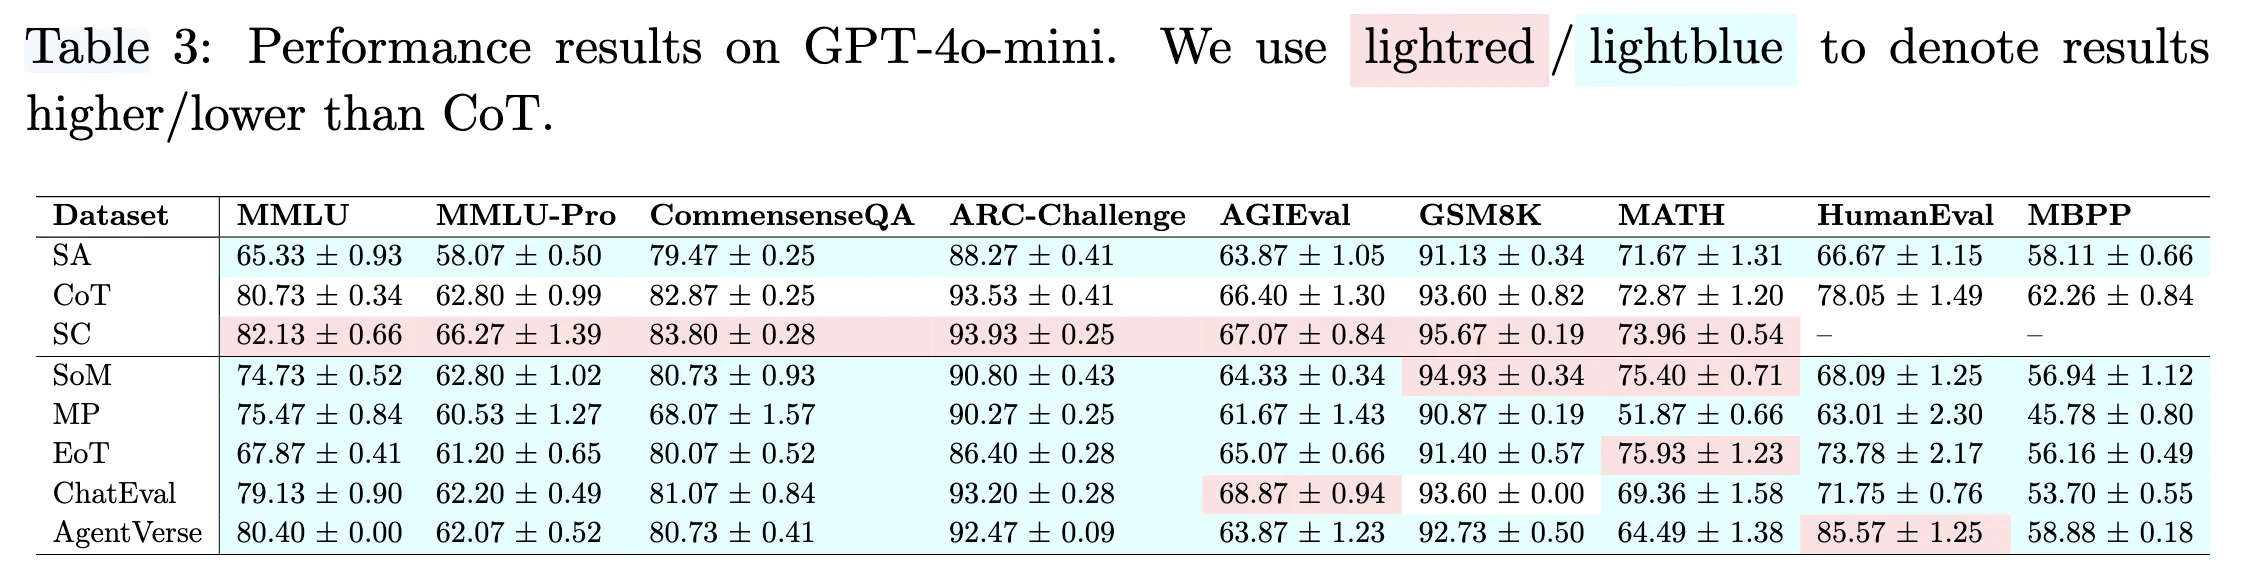
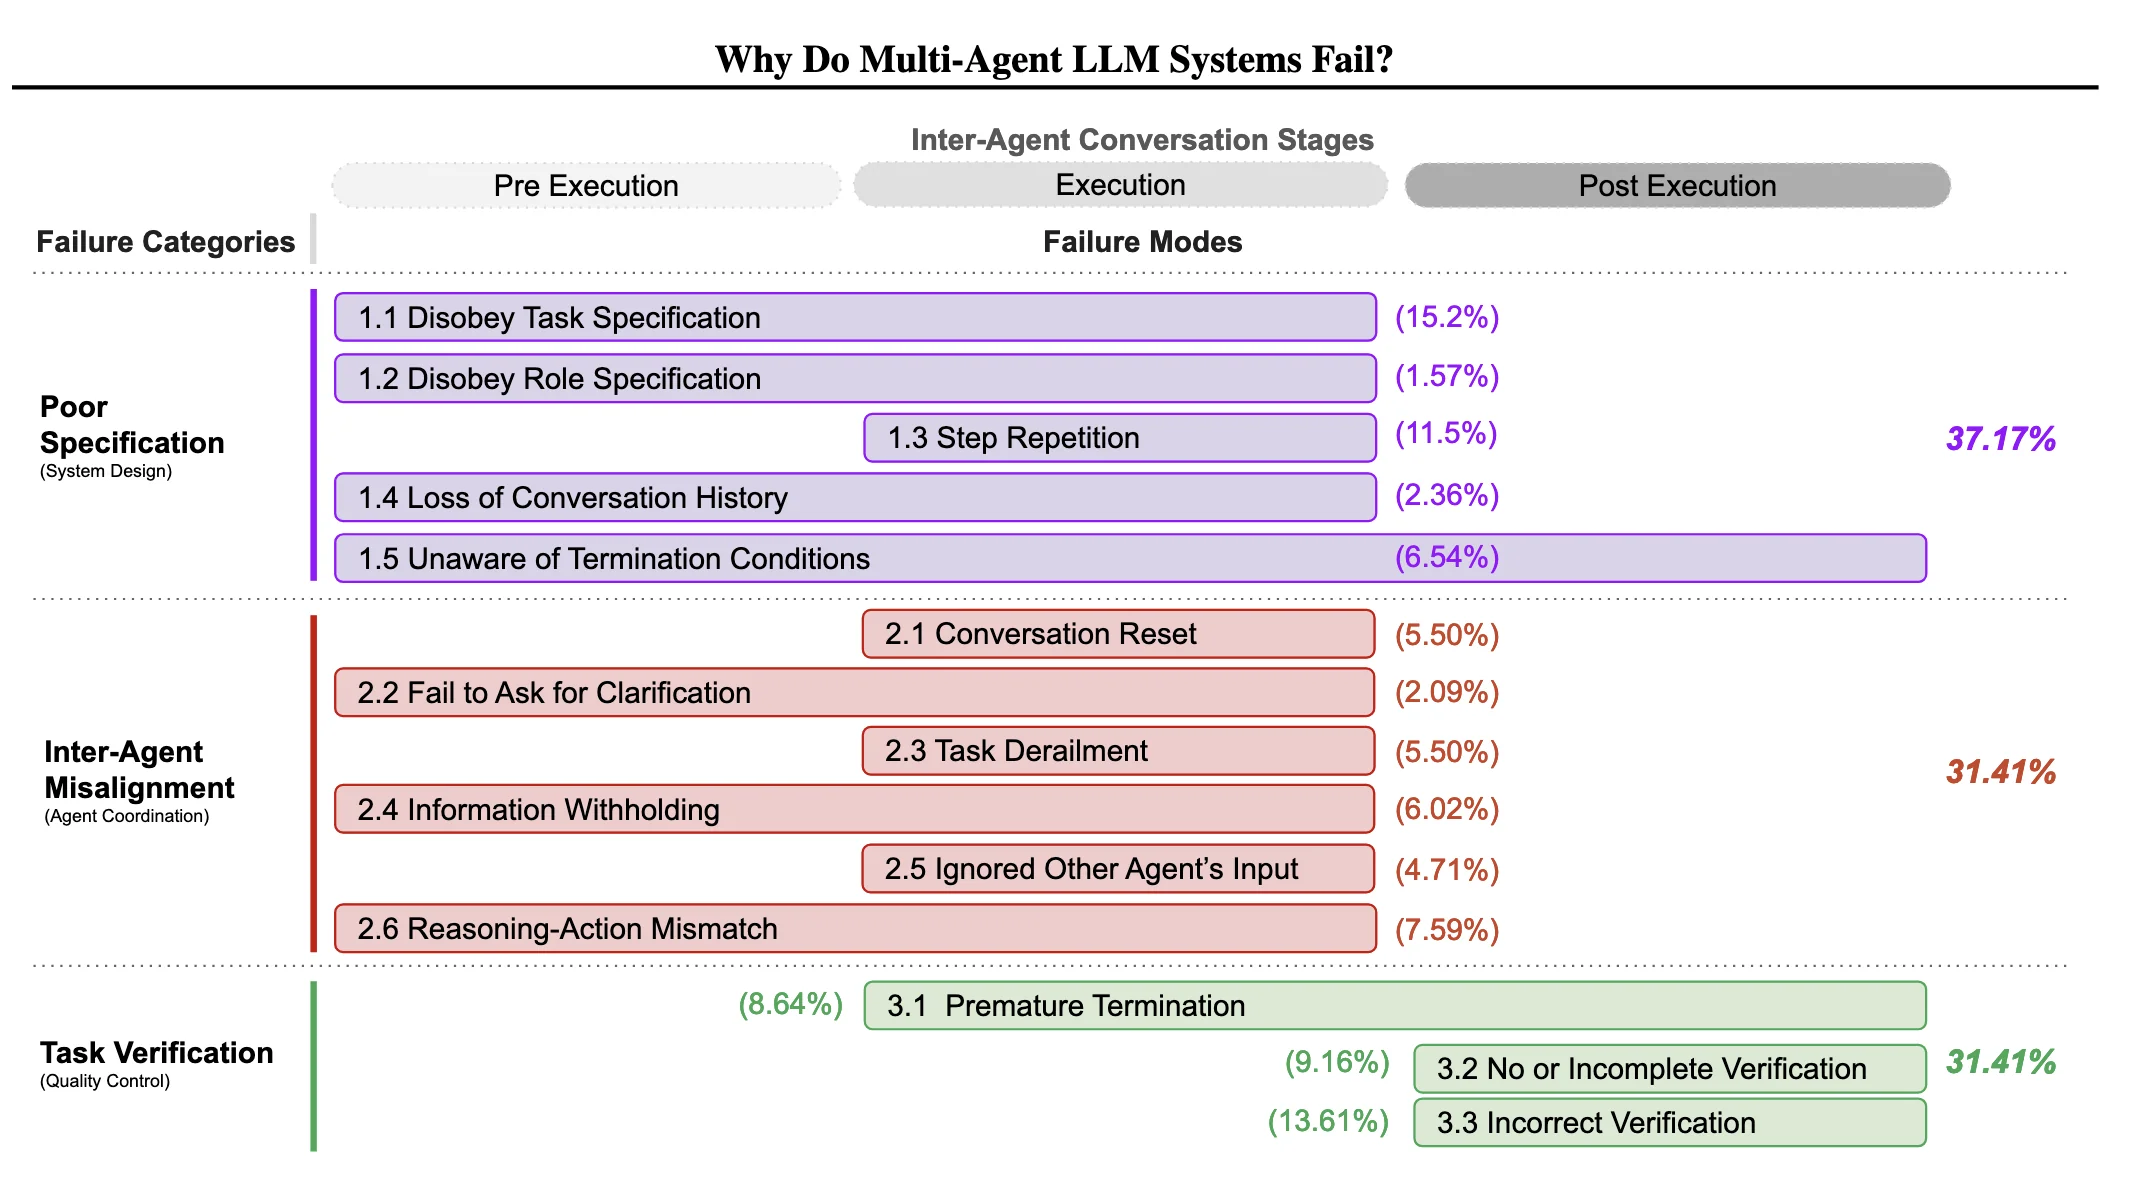
- 打不过单 agent:在推理、编程、问答任务上,MAS 常常跑不赢单 agent 的基线(简单的 0-shot CoT、Self-Consistency 等等)
- 原因:
- 协调开销过大、通信冗余
- 任务拆得不合理,制造出依赖冲突
- 验证机制不到位(占失败原因的 20%)
2. 协作上的缺陷#
- Agent 之间的错位:角色冲突、藏信息、推理和行动脱节
- 底层机制:
- 角色边界模糊(占失败原因的 15%)
- 缺少激励机制,目标对不齐
- agent 之间的差异性没利用起来
3. 评估的短板#
- 评估范围太窄:
- 任务面窄,基线也太弱(只有 15% 显著超过 CoT)
- 根本没有单 agent 基线
- 方法上的问题:
- 数据集有偏,领域覆盖有限
- 只顾准确率,效率和鲁棒性就顾不上
4. 扩展性挑战#
- 适应能力差:放到动态环境、复杂任务里,表现就不稳
- 结构上的限制:
- 通信拓扑固定(对性能的影响最高 6.4%)
- 记忆管理不到位,导致上下文丢失
改进方向#
-
结构优化
- 动态分配角色(AgentDropout 减少 21.6% 的 token)
- 层级架构(星型拓扑、流水线设计)
- 异构模型混用(性能提升 5.8%)
-
协作机制
- 按置信度加权投票
- 内置验证 agent
- 照心理学理论设计的冲突解决协议
-
评估框架
- 面向复杂场景的完整 benchmark
- 效率与效果并重的指标
- 用对抗测试检验鲁棒性
-
技术创新
- 记忆增强系统
- 基于 DAG 通信的因果推理模型
- 人在回路中的协作
MAS 研究正从探索转向以可靠性为目标的工程:理论上要有新东西,落地也得有能用的实现框架。
Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A., Chopra, B., Tiwari, R., Keutzer, K., Parameswaran, A., Klein, D., Ramchandran, K., Zaharia, M., Gonzalez, J. E., & Stoica, I. (2025). Why Do Multi-Agent LLM Systems Fail? (No. arXiv:2503.13657). arXiv. https://doi.org/10.48550/arXiv.2503.13657 Wang, Z., Wang, Y., Liu, X., Ding, L., Zhang, M., Liu, J., & Zhang, M. (2025). AgentDropout: Dynamic Agent Elimination for Token-Efficient and High-Performance LLM-Based Multi-Agent Collaboration (No. arXiv:2503.18891). arXiv. https://doi.org/10.48550/arXiv.2503.18891 Zhang, H., Cui, Z., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). If Multi-Agent Debate is the Answer, What is the Question? (No. arXiv:2502.08788). arXiv. https://doi.org/10.48550/arXiv.2502.08788
关于 MAS 开发的想法(截至目前;个人观点)#
设计模型、尤其是设计对话流程的时候,别搞人类中心主义。不要把人类理解世界的那一套想当然地套到这些系统上,设计决策应当从 LLM 自身的底层机制和原理出发。
关于对话历史#
不能拿人类理解“聊天记录”的方式,去解释 LLM 的回复生成机制。
多智能体系统里的 LLM 处理对话历史时,**“把整段材料读懂”比“一串按顺序来的用户输入”**更贴近它的运行方式。因为 LLM 是按“用户输入”这个范式训出来的(指令微调阶段尤其如此),也就是说,它从根子上就不适合多智能体系统。所以我们得做点机械的改造,把人类对多方对话的理解,转成 LLM 能处理的格式。
方法 1:照搬人类直觉的输入格式#
messages = [
    {"role": "assistant", "content": "Statement", "name": "Judge"},
    {"role": "assistant", "content": "Statement", "name": "Plaintiff"},
    {"role": "assistant", "content": "Statement", "name": "Defendant"},
    {"role": "user", "content": "Now, please..."},
]实测下来,这种写法会触发模型的“微调”模式。原理上讲:1)name 字段,模型根本看不到;2)模型会把 user 里的 content 当成“用户输入”,把 assistant 里的 content 当成“微调时它自己该给出的输出”,于是一次“微调”就自己跑起来了。
方法 2:用户输入按顺序给出(符合人类理解,但违背 LLM 原理)#
messages = [
    {"role": "user", "content": "[Judge]: Statement"},
    {"role": "user", "content": "[Plaintiff]: The following is the historical record"},
    {"role": "user", "content": "[Defendant]: The following is the historical record"},
    {"role": "user", "content": "Now, please..."},
]
实测下来,这种写法很难同时做到指令遵从好、幻觉少(连续的 user 输入会让模型抓不住用户意图),即使用大参数模型(比如 gpt-4o)也一样,它就是理解不了真正的“用户意图”。换成参数小一点的模型(比如 GPT-4o-mini),这场模拟基本就跑不起来了。
方法 3:阅读理解式(符合 LLM 原理,但和人类理解相去甚远)#
messages = [
    {"role": "user",
    "content": '''
    Below is the historical record:
    [Judge]: ...
    [Plaintiff]: ...
    [Defendant]: ...
    ...
    '''},
    {"role": "user", "content": "Next..."},
]
实测下来,方法 3 的指令遵从(意图理解)更好、幻觉更少,哪怕模型参数不大(比如 Qwen/Qwen2.5-32B-Instruct)也一样。我们还发现,这种方式把模型的语言能力彻底放了出来:连 32B 的模型(qwen-2.5-32b-instruct)都能在对话里给出很细、很具体的细节,而这种细节,用 gpt-4o 配方法 3 反而拿不到。
# 尽管我们没有解决证据具体内容生成的pipeline,但模型已经能够提供精细的具体细节

【原告律师】:针对法庭的要求,我方愿意当庭展示2016年5月2日的邮件记录,其中包括第一被告负责人王先生在10:15发送的确认提货邮件及我方张经理于10:25的确认回复邮件,我们有完整的邮件记录和张经理的确认信息,以确凿证据证明第一被告确实收到了提货通知并确认了提货时间。
---
【法官】:请被告陕西万鑫安装工程有限公司详细指出原告提交的管理费用和保险费用支付凭证中日期不符的具体凭证编号及金额,并提供反驳证据,以便法庭进一步审查其真实性和合理性。
【被告律师】:法官大人,原告提交的管理费用支付凭证中编号为007的凭证,日期与仓储明细记录不符,金额为5000元,请求法庭进一步核查该凭证的真实性和合理性。
关于 Prompt 风格#
训练时 LLM 的输出环境基本就是 markdown,所以它对 markdown 语法很敏感。人喜欢自然语言写出来的层级结构,LLM 偏偏吃 markdown 那一套层级。所以设计 prompt 的时候尽量用 markdown(比如多用几个 # 标题),模型更容易理解。
举个例子,
# 对话历史

- **法官**: ……
- **原告律师**: ……
- **被告律师**: ……
要好过下面这种:
以下是对话历史:[法官]: ……[原告律师]: ……[被告律师]: ……
按 LLM 的思路,前者更合适。
关于 Prompt 约束#
LLM 更懂 LLM。相比用人盯着、按 TDD 那一套手工改 prompt,让 LLM 来改效率更高。
把对话的表现喂给 ChatGPT,让它分析问题、调整思路,再把真正在用的 prompt 交给它,就能照着它的改法,有针对性地更新 prompt。实测下来,这样加约束又快又准。
参考文献#
本文里的很多想法和概念,来自我在研究中读到的各种学术工作。有些概念具体出自哪篇,我未必还记得清楚,只能尽量把影响过我思考的相关文献列出来。下面这些只是其中一部分。如果有重要的工作被漏掉,我在这里诚恳致歉。
Deshpande, D., Sourati, Z., Ilievski, F., & Morstatter, F. (2024). Contextualizing Argument Quality Assessment with Relevant Knowledge (No. arXiv:2305.12280). arXiv. https://doi.org/10.48550/arXiv.2305.12280
Iglesia, I. D. la, Goenaga, I., Ramirez-Romero, J., Villa-Gonzalez, J. M., Goikoetxea, J., & Barrena, A. (2024). Ranking Over Scoring: Towards Reliable and Robust Automated Evaluation of LLM-Generated Medical Explanatory Arguments (No. arXiv:2409.20565). arXiv. https://doi.org/10.48550/arXiv.2409.20565
Rocha, V. H. N., Silveira, I. C., Pirozelli, P., Mauá, D. D., & Cozman, F. G. (2023). Assessing Good, Bad and Ugly Arguments Generated by ChatGPT: A New Dataset, its Methodology and Associated Tasks (Vol. 14115, pp. 428–440). https://doi.org/10.1007/978-3-031-49008-8_34
Tran, K.-T., Dao, D., Nguyen, M.-D., Pham, Q.-V., O’Sullivan, B., & Nguyen, H. D. (2025). Multi-Agent Collaboration Mechanisms: A Survey of LLMs (No. arXiv:2501.06322). arXiv. https://doi.org/10.48550/arXiv.2501.06322
Zhuge, M., Zhao, C., Ashley, D., Wang, W., Khizbullin, D., Xiong, Y., Liu, Z., Chang, E., Krishnamoorthi, R., Tian, Y., Shi, Y., Chandra, V., & Schmidhuber, J. (2024). Agent-as-a-Judge: Evaluate Agents with Agents (No. arXiv:2410.10934). arXiv. https://doi.org/10.48550/arXiv.2410.10934
Razmyslovich, A., Murasheva, K., Sedlova, S., Capitaine, J., & Dmitriev, E. (2025). ELTEX: A Framework for Domain-Driven Synthetic Data Generation (No. arXiv:2503.15055). arXiv. https://doi.org/10.48550/arXiv.2503.15055
Sengupta, S., Vashistha, H., Curtis, K., Mallipeddi, A., Mathur, A., Ross, J., & Gou, L. (2025). MAG-V: A Multi-Agent Framework for Synthetic Data Generation and Verification (No. arXiv:2412.04494). arXiv. https://doi.org/10.48550/arXiv.2412.04494
Wu, S., Huang, Y., Gao, C., Chen, D., Zhang, Q., Wan, Y., Zhou, T., Zhang, X., Gao, J., Xiao, C., & Sun, L. (2024). UniGen: A Unified Framework for Textual Dataset Generation Using Large Language Models (No. arXiv:2406.18966). arXiv. https://doi.org/10.48550/arXiv.2406.18966
Chen, W., Su, Y., Zuo, J., Yang, C., Yuan, C., Chan, C.-M., Yu, H., Lu, Y., Hung, Y.-H., Qian, C., Qin, Y., Cong, X., Xie, R., Liu, Z., Sun, M., & Zhou, J. (n.d.). AGENTVERSE: FACILITATING MULTI-AGENT COLLAB- ORATION AND EXPLORING EMERGENT BEHAVIORS.
Li, G., & Ghanem, B. (n.d.). CAMEL: Communicative Agents for “Mind” Exploration of Large Language Model Society.
Li, J., Wang, S., Zhang, M., Li, W., Lai, Y., Kang, X., Ma, W., & Liu, Y. (2024). Agent Hospital: A Simulacrum of Hospital with Evolvable Medical Agents (No. arXiv:2405.02957). arXiv. http://arxiv.org/abs/2405.02957
Li, J., Zhang, Q., Yu, Y., Fu, Q., & Ye, D. (2024). More Agents Is All You Need (No. arXiv:2402.05120). arXiv. http://arxiv.org/abs/2402.05120
Park, J. S., O’Brien, J., Cai, C. J., Morris, M. R., Liang, P., & Bernstein, M. S. (2023). Generative Agents: Interactive Simulacra of Human Behavior. Proceedings of the 36th Annual ACM Symposium on User Interface Software and Technology, 1–22. https://doi.org/10.1145/3586183.3606763
Qian, C., Liu, W., Liu, H., Chen, N., Dang, Y., Li, J., Yang, C., Chen, W., Su, Y., Cong, X., Xu, J., Li, D., Liu, Z., & Sun, M. (2024). ChatDev: Communicative Agents for Software Development (No. arXiv:2307.07924). arXiv. http://arxiv.org/abs/2307.07924
Wang, L., Zhang, J., Yang, H., Chen, Z., Tang, J., Zhang, Z., Chen, X., Lin, Y., Song, R., Zhao, W. X., Xu, J., Dou, Z., Wang, J., & Wen, J.-R. (2024). User Behavior Simulation with Large Language Model based Agents (No. arXiv:2306.02552). arXiv. http://arxiv.org/abs/2306.02552
Wu, M., Yuan, Y., Haffari, G., & Wang, L. (2024). (Perhaps) Beyond Human Translation: Harnessing Multi-Agent Collaboration for Translating Ultra-Long Literary Texts (Version 1). arXiv. https://doi.org/10.48550/ARXIV.2405.11804
Xu, Y., Wang, S., Li, P., Luo, F., Wang, X., Liu, W., & Liu, Y. (2024). Exploring Large Language Models for Communication Games: An Empirical Study on Werewolf (No. arXiv:2309.04658). arXiv. http://arxiv.org/abs/2309.04658
Zhang, C., Yang, K., Hu, S., Wang, Z., Li, G., Sun, Y., Zhang, C., Zhang, Z., Liu, A., Zhu, S.-C., Chang, X., Zhang, J., Yin, F., Liang, Y., & Yang, Y. (2024). ProAgent: Building Proactive Cooperative Agents with Large Language Models. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16), 17591–17599. https://doi.org/10.1609/aaai.v38i16.29710
Zhang, C., Li, R., Tan, M., Yang, M., Zhu, J., Yang, D., Zhao, J., Ye, G., Li, C., & Hu, X. (2024). CPsyCoun: A Report-based Multi-turn Dialogue Reconstruction and Evaluation Framework for Chinese Psychological Counseling (Version 3). arXiv. https://doi.org/10.48550/ARXIV.2405.16433
致谢#
本文写于我在 TsinghuaNLP 的 Legal AI 组实习期间。