〇、引子
持续学习(Continual Learning),一点也不性感。早在Transformer发表之前,DeepMind就在PNAS上讨论过灾难性遗忘(Catastrophic Forgetting):神经网络学了新任务就会冲掉旧能力,所以我们要想办法保留我们在乎的权重1。
LLM 之后,几年间没人讨论这个词了。一瞬间所有人都在预训练,然后所有人都在做强化学习,然后所有人都在做Agent和Harness,好像除了社区的吐槽之外,大厂不是非常关心模型用起来“顺不顺手”,和用户兼容几分。如果硬要表达同样的概念,大家会用微调(Fine-Tuning)、适配(Adaptation)、个性化,但始终带着一些2023年的古早味。
为什么在2026年年中,这个词又冒出来了?
不少基座在冲击10T参数量了,并且前沿Lab的大基座“你方唱罢我登场”,几个月一轮换,刷新的都是几乎一模一样的能力,大家累了。这么大的模型,没人微调得动;更新换代这么快,也根本没人微调得及2。榜单上都是神挡杀神佛挡杀佛,实际在自己的工作流里用下来,谁还不骂几句“怎么这么不懂我”。
于是持续学习又被翻出来:现在基座已经够用了,如基座能够在使用中调整自己,不断学习,最终真的“长成”我的样子,那该多好?
但至少在2026年9月的今天,这个愿景还没有实现。所有人都只是在“租”Agent,而不是真正“拥有”Agent。
一、持续学习,四条路
第一,全参重训。 类似继续预训练(Continued Pre-training, CPT),这只存在于幻想时刻,真实情况是你的数据质量不一定有基座pretrain数据好,分布不一定有它科学,甚至倒打一耙损伤通用推理能力,以及抛开这些不谈,最重要的,就连大厂也难有这么多计算资源,专门为一个领域、甚至一个个体做如此贵价而不知对错的适配。
第二,参数高效微调(PEFT),冻结基座,只训一小片新参数。2019 年 Adapter 往 Transformer 层间加小模块3;2021 年 Prefix-Tuning 只学每层输入前面的连续向量,参数量不到全模型的千分之一,效果接近全量微调4;半年后 LoRA(Low-Rank Adaptation)把增量约束成两个低秩矩阵的乘积,可训练参数少了四个数量级,GPT-3 175B 的checkpoint从 350GB 缩到 35MB5。然后就是,LoRA 挂在哪些层、学习率开多大这种工程优化6。
第三路, 不动参数,靠检索与记忆。首先,参数是怎么支持记忆的?这里需要稍微讨论一下memorization-generalization paradox。
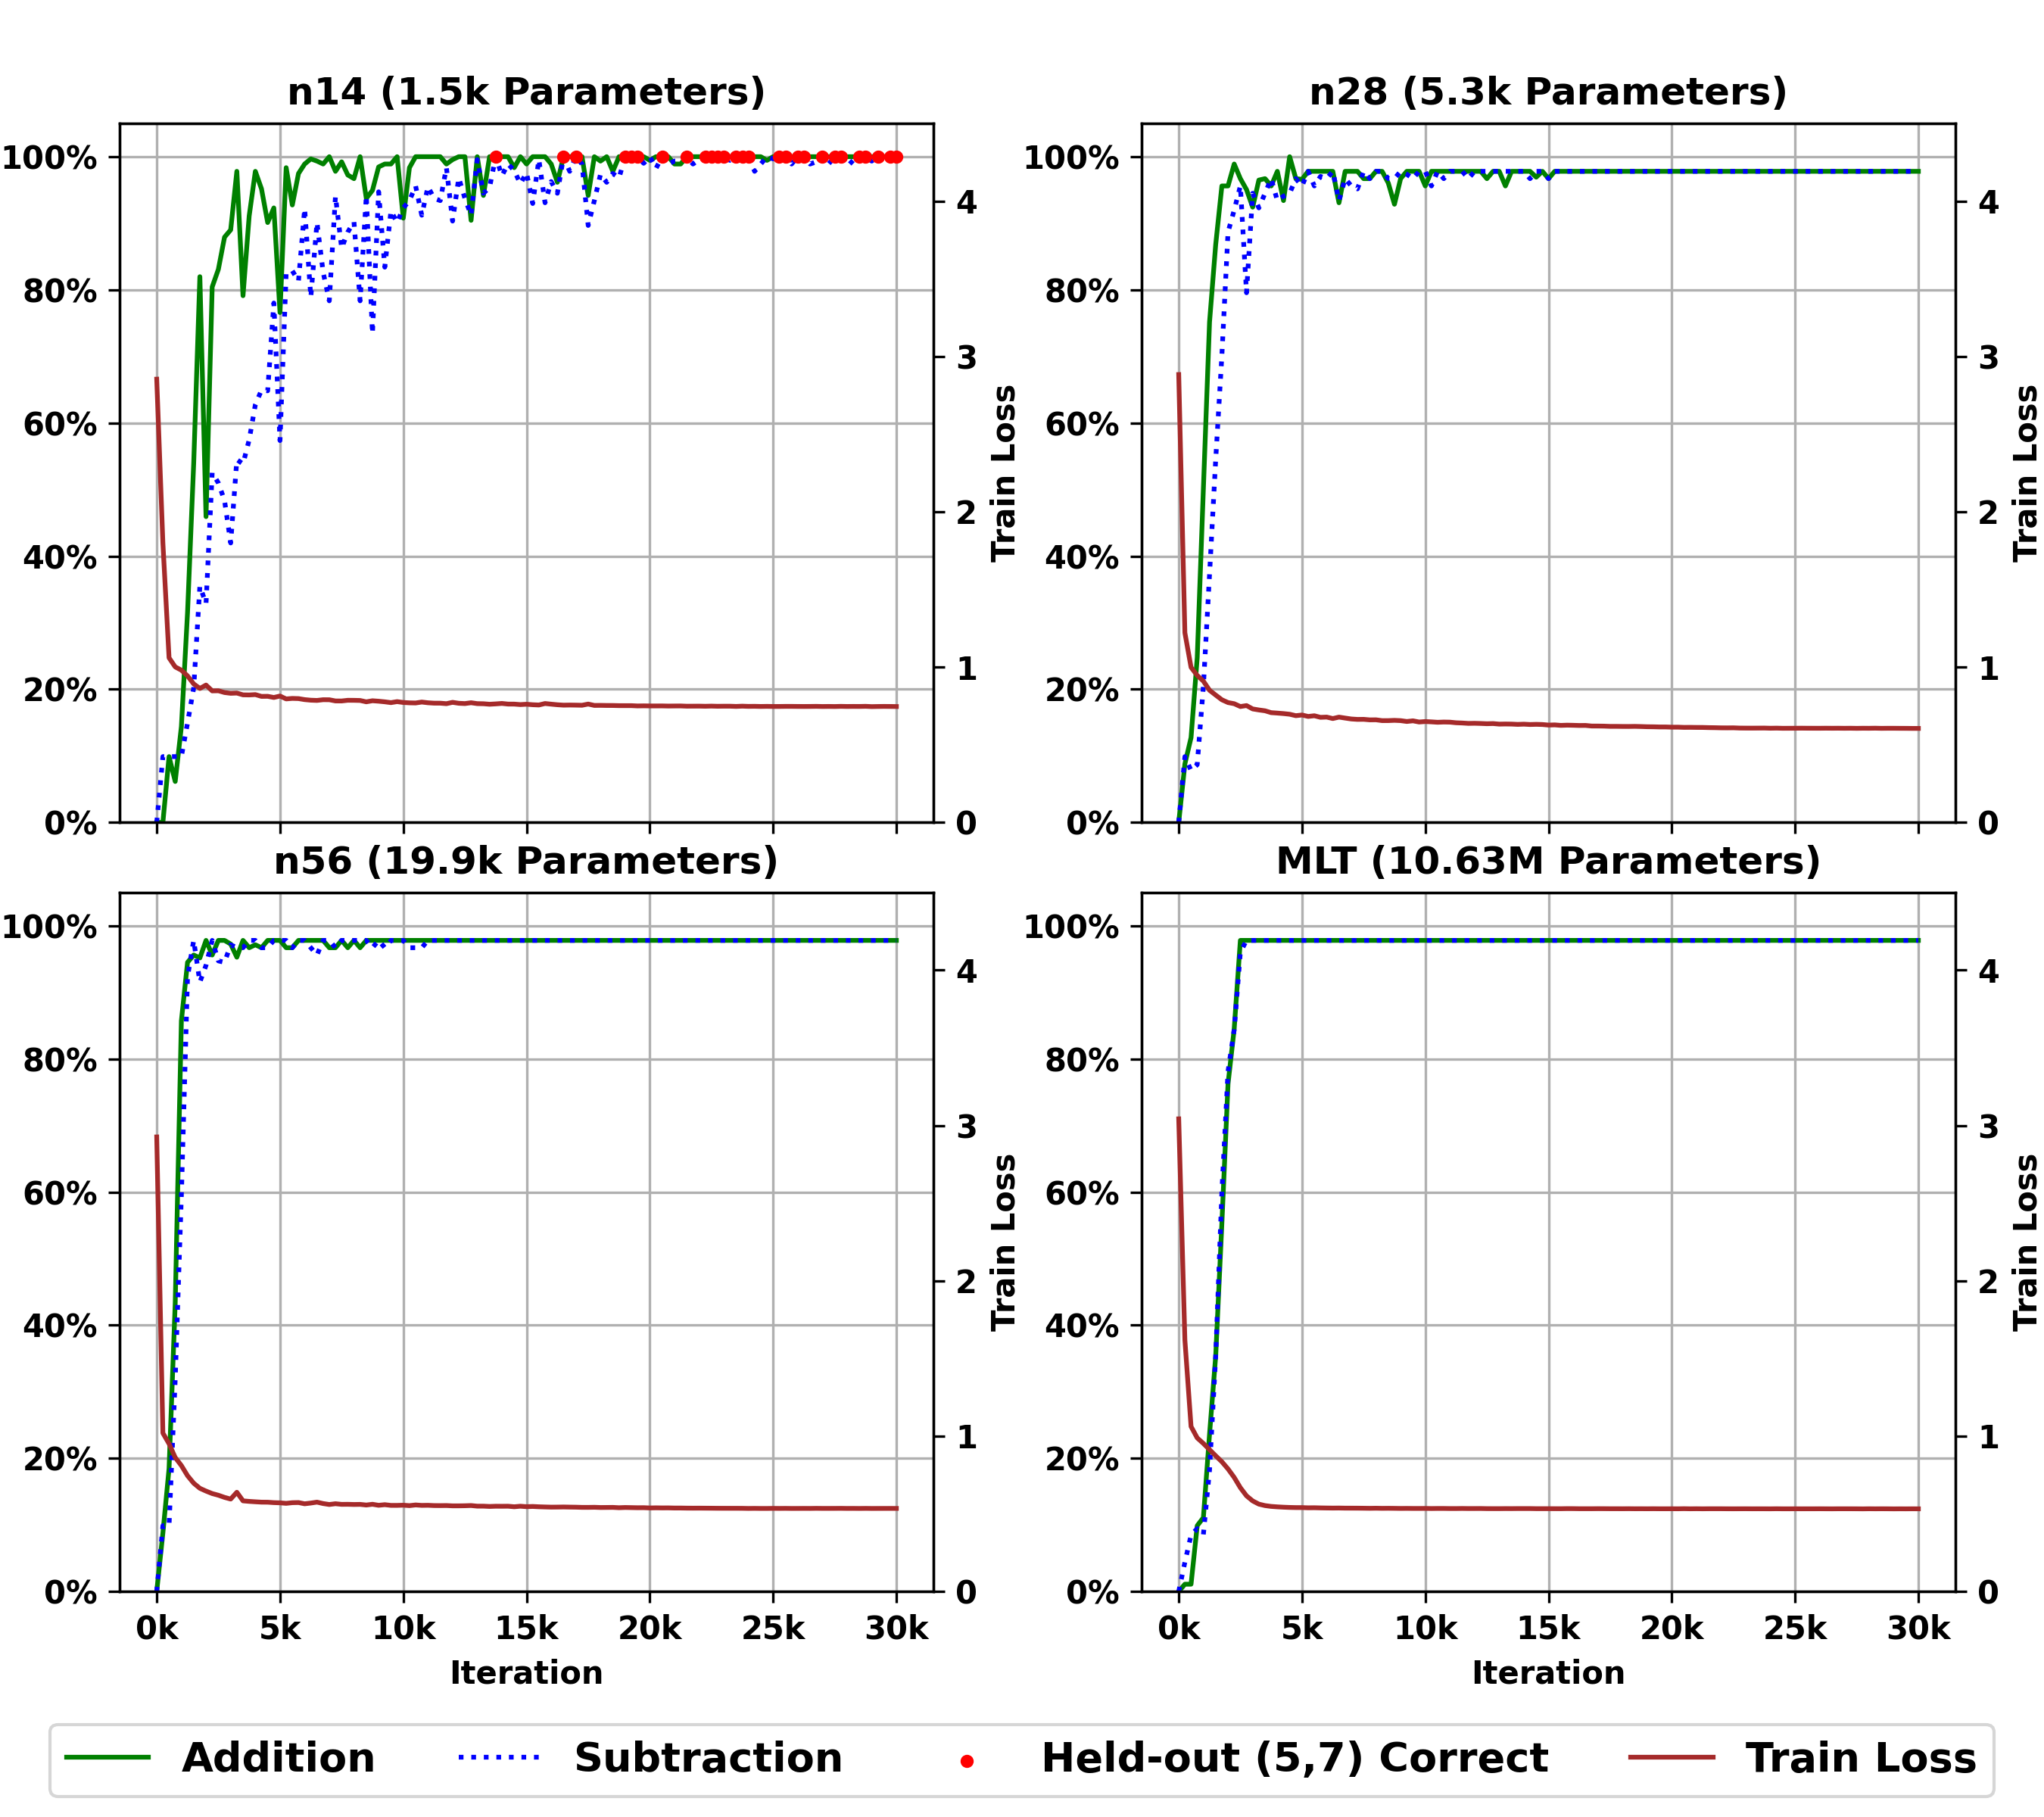
Google在2017年演示过,深度网络连随机的标签都能背下来,说明模型可能光记忆而不找规律7,8年过后的ICML 20258还在callback,发现大的模型会把训练数据背下来、绕开思考,而小模型能外推(extrapolate)但记不住事实。
Meta 后来在2024年发现,每个参数恰好存 2 比特知识,量化到 int8 也不变9,梯度下降本身决定了,模型记一个样本只动几个参数,loss降得很快,学出一个规律要动一片参数,就慢得多。架构侧我们可以用同一组参数对同一段输入反复计算,逼它执行算法而非背诵10。那如今大参数的优势在哪?Goodfire和Anthropic说,是长尾场景:现代的训练数据工程成熟了,数据变diverse之后,小模型的神经元只能handle高频任务,长尾的任务即便solution存在也学不进去,并且和高频任务的能力存在干扰11,换言之,“小模型永远追不上大模型”。
但“你的长尾我的长尾好像不一样”,谁也无法保证自己永远是“多数的长尾”。于是 “知识搬出参数、参数专职泛化” 逐渐成为一种范式:检索、外挂记忆、层级记忆应运而生。DeepSeek 甚至把外部记忆做进了架构,用 Engram 模块、常数时间查表来承担静态知识,等参数、等算力下全面胜过纯 MoE 基线12。但检索管不了怎么“取舍”,它只能给你事实,却给不了你偏好。“在一个新的session里莫名其妙记起你之前说过什么东西,这没什么意义。”
这就过渡到第四路,最便宜的一层:提示词。从Prompt Engineering到Context Engineering的工程纪律洗礼之后,Skill作为集大成者应运而生。渐进式披露、按需读取、协议化使用、指令和脚本分开,使其一度成为解决长尾的版本答案,这里先按下不表。除此之外,从前做本体论和知识图谱的那帮人也开始狂欢,演化出无数的File-based Memory、Andrej Karpathy的LLM Wiki,以及谷歌的Open Knowledge Format。
其实还有第五条小众路线,推理时直接干预模型内部激活(Steering),加个向量13或者解码约束14,论文不少,但是否真的比Prompt好用,有待检验。
四条路背后,一个是灾难性遗忘的科学问题,另一个是工程问题:无论是adapter、prompt还是harness都挂在基座上,基座一变,效果就可能大打折扣;而如果原来挂的是adapter,则直接不可用。
二、苦涩的教训:人类从不汲取教训
让我们暂时先回到LLM刚爆发后的Good Old Times,当时要做持续学习怎么办?在当时prompt只是奇技淫巧(思维链刚被发现,随后随便加点什么到prompt里都能发点东西),似乎不够严肃,大家的共识是要微调,要参数高效微调(Parameter-Efficient Fine-Tuning, PEFT),要LoRA。
一个看起来已经解决的问题,学术界围着它又研究了三年。2021 到 2024,rank 怎么分配、矩阵结构够不够优雅、多个 LoRA 能不能合并、合并之后能不能路由、路由之后能不能按输入动态选择,每个问题都值得再发一篇。小红书上有一篇复盘(其实正是这篇文章动笔之发心),把这三年称作 PEFT 的“雕花时代”15。
“雕花”在 2023 年前后凝结成一句口号:基座模型是操作系统,LoRA 是 App。这个叙事太对味儿了:操作系统管底层复杂性,应用管轻薄、即插即用,中间是一整个应用商店的商业想象。LoraHub 用无梯度优化把现成 LoRA 模块组合出没学过的新任务16;多 LoRA 服务让成百上千个adapter共享一个基座,行业上上下下都信了:智能可以插件化。
“各大中小厂争相推出了五花八门的插件市场 + 支持热插拔的智能一体机,这套方案他们简直太喜欢了,完美与彼时的ToB市场口味契合,连带着整个学界都洋溢着一种炼金术式的乐观。”
后面的故事大家都知道了,我们并没有进入LoraHub预测的未来。
组合性(Compositionality)最先塌方。把多个任务的任务向量直接相加,并不总能同时提升所有任务——合并出的模型总是赶不上各任务的专才版本17;而单纯的模型合并(Model Merging)其实也存在理论上限:随着合并数量增多,边际收益递减18,参数间的干扰还会让合并结果大幅掉点19,即使两个 LoRA 在子空间上严格正交,合并后照样没有语义解耦,搅在一起之后,多数时候只是套了一层浅层的模式。
然后是 Reflection 70B,可以说是故事的高潮。2024 年 9 月,这个模型拿自我反思数据在 Llama 3.1 70B 上做 PEFT 微调,榜单成绩一度起飞,被包装成最强开源模型,但权重至今没有开源。几天后 OpenAI 发布 o1,四个月后 DeepSeek-R1 开源,大家才看明白 thinking 这件事远远没有那么trivial。Reflection 退化为一件“文物”,说明人们曾经真的相信过,LoRA 挂得够好,就能从基座里抠出一种新能力。
PEFT没有成为AI世界的App Store……没有证明智能可以被拆成几十个低秩插件,然后像乐高一样自由组合。也没有证明真正的 reasoning 藏在某个神秘的低秩子空间里,等着研究生用8张卡把它挖出来。智能没有捷径。
Richard Sutton 在《苦涩的教训》里说,长期看,依赖人类巧思的方法赢不过算力和规模20,曾经的 PEFT 宏大叙事,也只是为它新添了一则证据。
但人类从历史中汲取的唯一教训,就是人类从不汲取教训。
三、死灰复燃
狂热褪去,LoRA的价值究竟在哪?学界逐渐为其在两个方向上“纠偏”。
第一,上限。 数学上,低秩参数空间只是全量微调空间的严格子集,而且小到测度为零21。但另一面是,当任务与基座的差异本身是低秩的,LoRA 严格优于全量微调22。分界线大致在数据量:几千条样本的区间,LoRA 更具性价比;数据涨到百万量级、更接近继续预训练式的知识灌输时,全量微调才会反超23。Thinking Machines Lab把LoRA作用于全部层、学习率开到全量微调的十倍,发现绝大多数后训练场景里 LoRA 与全量微调的样本效率和最终性能完全持平;跑强化学习时 rank-1 就够了,因为一个回合的奖励携带的信息常常不到一个比特。也就是说,只有往模型里灌输海量新知识时,LoRA 才开始落后24。
所以LoRA远非一文不值:想让模型学全新知识(一门全新的语言、极不常见的词语组合),别指望小参数;想让模型重组已有的能力,比如学一个人的口吻、一套决策的风格,LoRA 正好处在优势区。LoRA 原论文自己就测过:微调增量 恰好放大了那些在基座权重里“重要却没被强调”的方向5。秩为4的增量,每层大约只挑4个这样的方向,放大高达20多倍;秩放到64,放大倍数就跌回约2倍。LoRA 学的从来都是已有表征的重新配比。
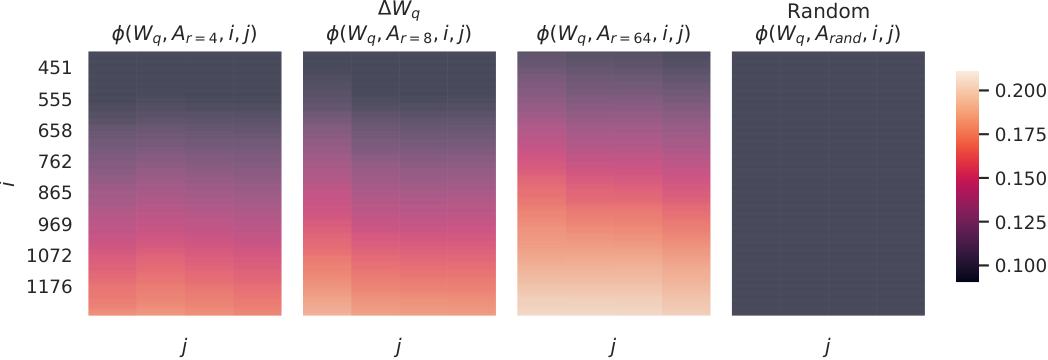
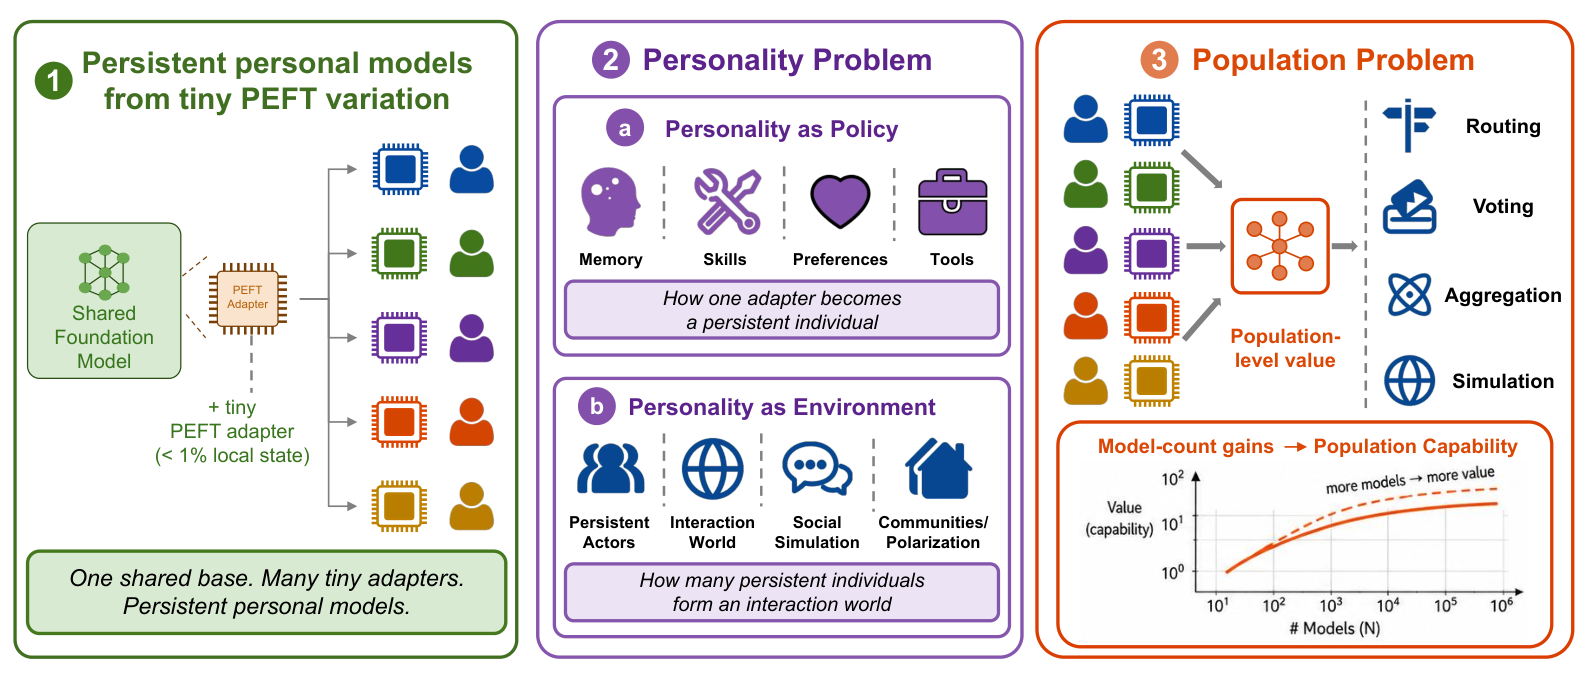
第二,形态。 答案不是合并,是路由。谱分析显示,顺序合并 LoRA 会累积出全量微调训练中几乎不会出现的“入侵维度”(intruder dimensions),越合并退化越快25。同年的 Mixture of LoRA (MoL) 用门控网络组合冻结的 LoRA 池26,此后两年这条线一路演进,到 2026 年年中,Mind Lab 把油门踩到了底——6 月发研究论文《On the Scaling of PEFT》论证,8 月发技术报告 Macaron-V1 落地:
- DeepSeek-R1-Distill-Qwen-32B 挂 0.07B 的 LoRA,AIME 2025 归一化提升 20.61%,反超同系列 1.5B 模型的全参强化27;
- 同一个基座(Qwen3-30B)、同一份数据、同一套超参,仅仅靠数据入场顺序等扰动不同训了 198 个 LoRA 做 majority voting,让 AIME24 从 36.4% 涨到 48.7%27;
- 报告给出的产品形态:GLM-5.2 744B 的基座整个冻结,能力装进四个约 1B 的 LoRA 专家(Chat 对话、Agent 生活助理、Coding、GenUI),甚至不设单独的路由模型,由入口专家 L0 自己按请求选专家。新能力等于挂一个新 LoRA,旧能力完全不动28。
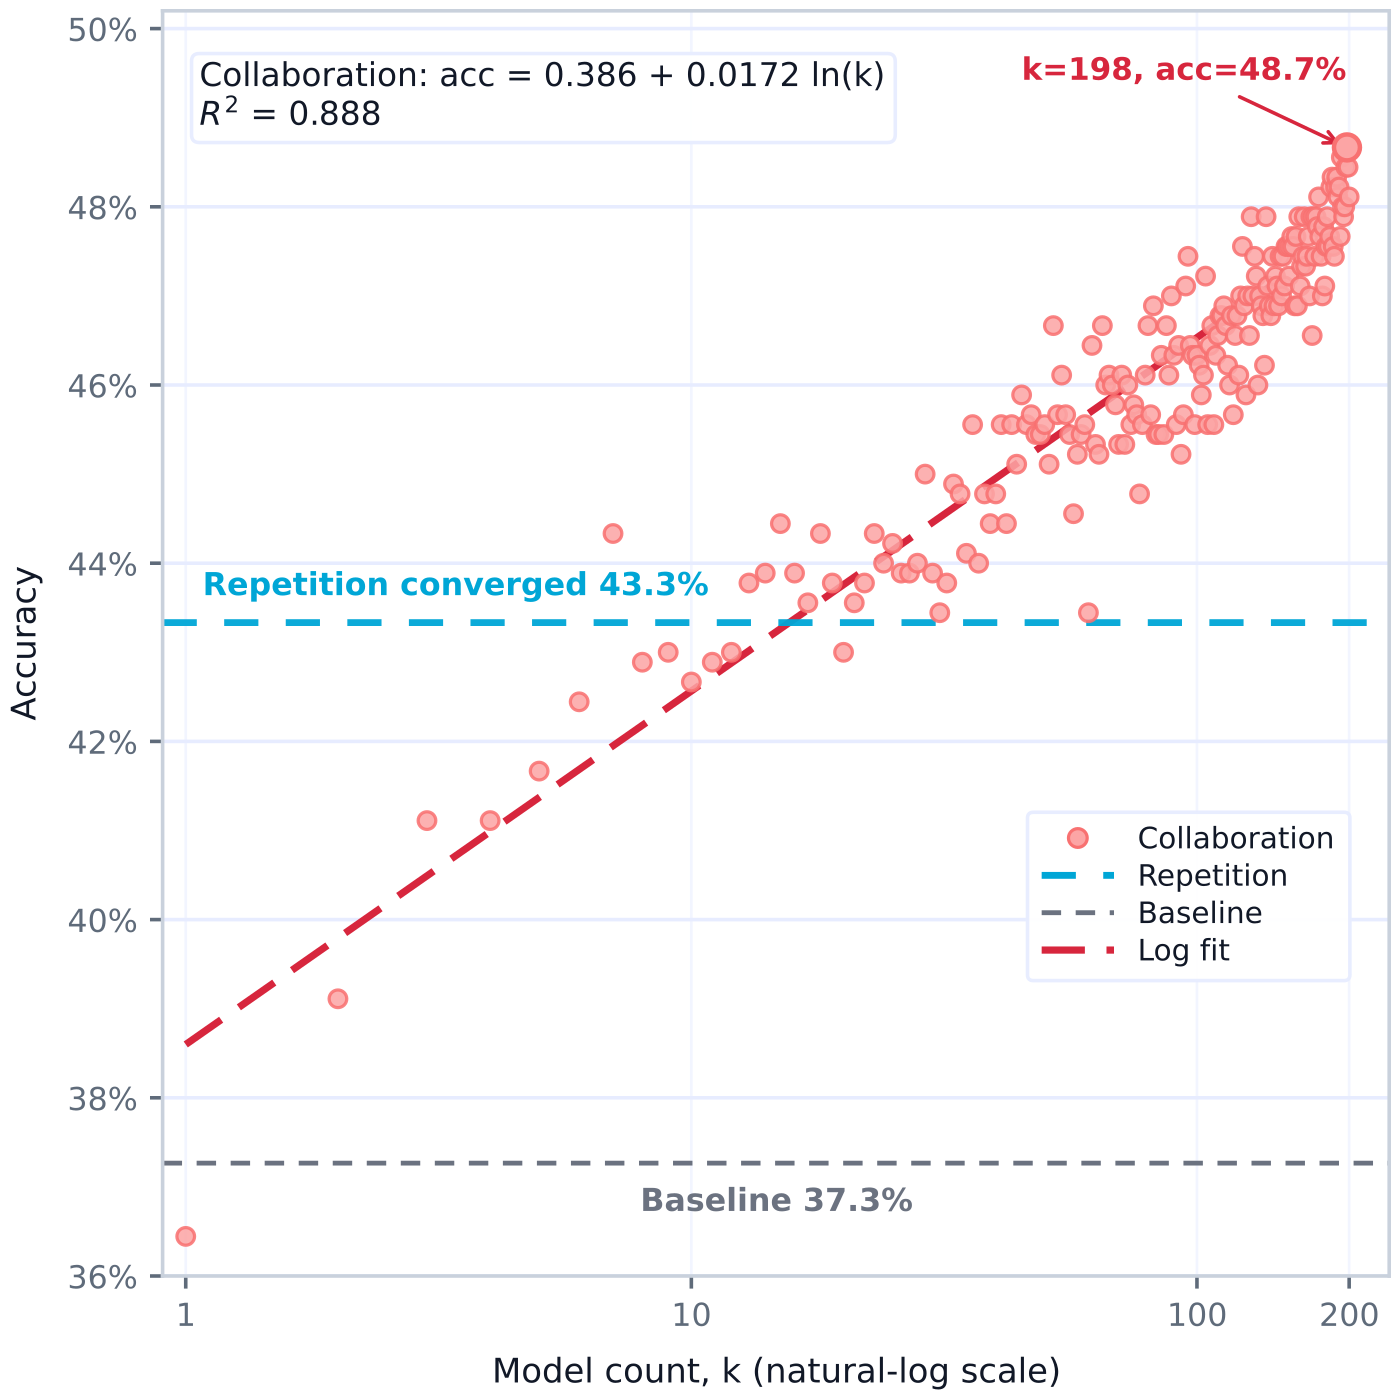
他们押注的点在于:(1) 先验的强度可能比可训练参数量更重要;(2) 不同 LoRA 变体在多数投票下能产生群体智能。不过目前按用户训练“个人 LoRA”在报告里还是future direction,线上交付的是四个固定的专家。故事讲得震天响,“百万级持久的个人模型”,B 端把训练与托管开放成 API,按 token 计费;C 端做了 Macaron,一个带深度记忆的个人智能体:线上跑的就是这套 MoL 架构,一个冻结的基座,四个全体用户共享的固定专家,按用户轮次路由;而“每个用户自己的偏好、记忆与工具”,眼下是由一套外挂的Agentic Memory系统伺候的,“一人一片 LoRA”还在路上。订阅收费,商业化约两周,ARR 1000 万美元。
但即使“一人一片”能成,专家、记忆、用户偏好全都长在同一个基座上,基座过时了怎么办?用户想要更新的基座能力怎么办?他们(至少在公开的材料中)只能暂时噤声。GLM早就进化到5.3了,他们的一整套还建立在5.2上,一代还好,长久来看呢?
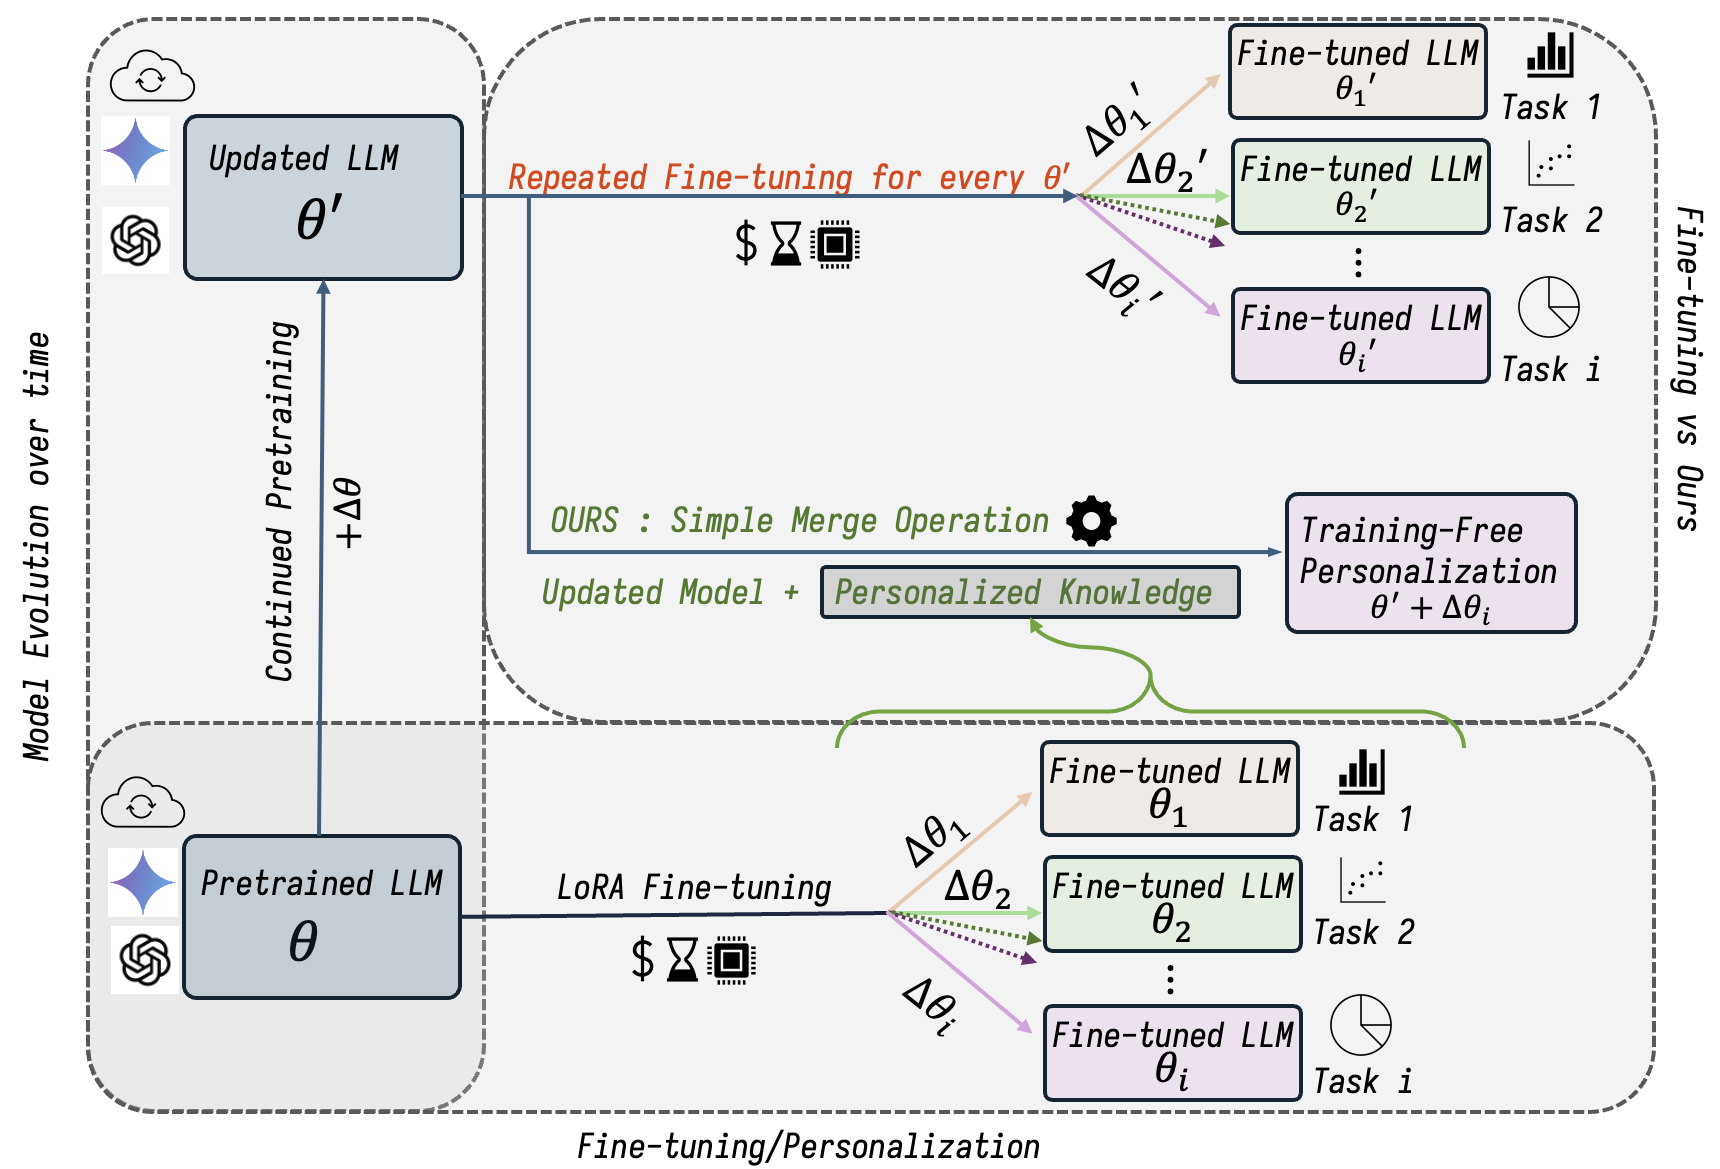
关于“换基座”和LoRA,有一篇24年的工作叫PortLLM:在老基座上照常做一次 LoRA 微调,得到一片补丁;等厂商继续预训练(CPT)出新一代基座,把补丁直接矩阵相加过去。凭什么呢?论文把“在新基座上重新微调”的理想答案做了代数分解:,残差度量的是“补丁本来会变多少”,实测它平均比主项小 66 倍、最高约 96 倍。也就是说,CPT(文中是模拟)确实大幅移动了基座,但你的任务所需要的那个方向,几乎没动29。结果表明,直接相加与重新微调相比性能下降不到一个点,个别任务不降反升;在 Mistral、Llama、Gemma 各家族上、跨作者模拟的连续多代基座更新都成立。但补丁只在同族迁徙,从 Llama 迁到 Qwen 这类跨家族是明确的future work。
另一头,OpenAI 已宣布收缩微调 API,2027 年 1 月起停止创建新的微调任务30。闭源微调在收窄,开源基座加可学习参数层,又复苏了。
四、事物发展规律、人民群众需要
读者或许一直揣着一个问题:难道近一年最火的不是Skill吗?哪里有人在玩参数空间?
的确,2026年9月的今天,Skills做长尾几乎已经成为铁律。
Skill 不是技术上优雅,而是用起来爽。把模糊的偏好写成清晰的规则,这件事本身就能给人类带来一种“我真厉害”的愉悦,md里加一行限制,只要模型够强,效果立竿见影,如Tim O’Reilly所言,“隐性知识首次可执行”31;规则是自然语言,读得懂、改得动、可审计,随着OpenClaw和Claude Code的热度左脚踩右脚螺旋升天,又在各种SkillHub和GitHub的支持下迅速形成生态;写完一个 Skill,手里摸得到一份实实在在的劳动成果,然后迅速分发、传播,而不像调参“炼丹”,只能对着loss和accuracy干瞪眼。
更妙的是一种全民的语言狂欢:Skill把“蒸馏”这个词给带火了,蒸馏专家、蒸馏同事,人走Skill还在,发展到大厂生产Skill的竞赛和tokenmaxxing竞赛同步,乃至发展到小扎给员工装屏幕监控收数据训模型。FOMO、媒体、平台的推波助澜,一起把Skill做成了气候。
Skill很好用,但大家讳莫如深的是,Skill有天花板:自然语言规则无法 scale up。
今年5月,翁家翌写了《Learning Beyond Gradients》这篇博客,用agent维护规则来打砖块、控制仿真机器人,说堆规则比训网络来得强,给持续学习提供了一条替代道路:学习不止梯度一条路,传统的启发式、专家系统、“手写”规则同样能被学习、被维护,“过去很多 heuristic 不是没用,而是没人养得起”,而coding agent几乎把维护成本压为了032。
但这样一种范式跑通的全是 “改动了就马上能看指标” 的场景:游戏操作能看分数,代码提交能看报错。但自然语言哪里有这种路径?“不要说不是而是”“不要用破折号”“不要动不动就用隐喻”“言之有物一点”“不要甩抽象大词”,最后还是只能交给人类去慢慢“品”合不合适——我们很难一开始就给模型写一份事无巨细的操作手册,而往往只能在模型犯傻、血压飙升的时刻才发现“这里不对”“那里不对”。
连可验证的指令,模型遵循都会随prompt增长而衰减3334,就更别提不可验证的了;并且context一长,模型有attention sink(注意力涌向开头)35,有lost in the middle36,只能虔诚祈祷模型还记得。所以我们不可能在SKILL.md里一次性放500条约束,这与模型的原理相悖。并且,就算这样能work,换了模型、模型升级(Prompt Migration),成百上千条精心打磨的特设规则也会集体失效37。 再且,那些能赢过微调的“超级提示词”,没有一个出自人手,全是强化学习优化出来的38,能 scale 的提示词,已经不是自然语言了。
眼下,行业对“长尾”的标准答案,Anthropic 给过一些完整示范,概括起来:单模型 Agent Loop 打主干,Skills 接长尾,工具调用既有系统,Harness 强制执行规则,快照式评估39。似乎已经收敛到了一个很合适的地方,但我们不禁想问,自然语言的In-Context Learning(ICL)真的能接住一切长尾吗?换言之,参数还能承载什么prompt承载不了的东西?
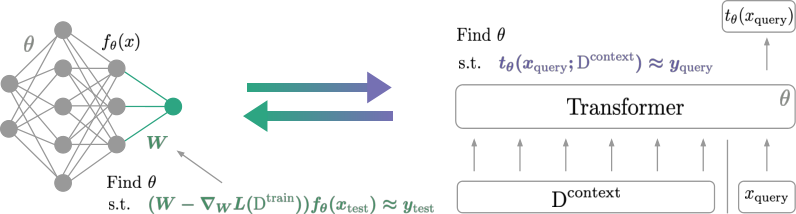
再向底层追溯,一个更理论的问题是:prompt和微调到底何时等价? 2022年以来已经有一批工作回答了这个问题。Prompt对注意力的改变,与一步线性梯度下降,在理论上是同构的40:
| 微调 | ICL | |
|---|---|---|
| 拿什么算 | 训练集样本 | prompt |
| 更新什么 | 权重矩阵 | 矩阵的临时增量 |
| 学习率 | 超参 | 注意力(每层每头的query和key算出来的) |
| 何时发生 | 训练时,多次迭代 | 推理时,一次前向,每个注意力头“下降”一步 |
| 结束后 | 权重留下,能力持久 | 激活清空 |
反过来,有人手工构造出每层执行一步梯度下降的 Transformer,训练出来的模型表现也可以吻合41。所以,微调是买参数,堆提示词是在租参数,租期从一个上下文开始,到上下文结束。短期内,租来的和买来的是同一个东西。
租和买,能承载的东西本来就不一样。 自然语言能承载那些“说得出口的部分”:步骤、规则、约束;参数承载的是另一类内容:分布、习惯、经验、搭配、口吻的分寸、取舍、直觉、面对模糊时的姿态,这些东西杂乱、宽泛、个人化,天然写不成清晰的prompt或者few-shot示例,只能进参数,靠数据喂出来42。而这一部分的痛点,目前所有人都只能忍着,因为整个行业几乎在朝着同样的地方收敛。Dwarkesh Patel 上个月写了《持续学习时代的八个预测》43,简要概括:
- 基座天天更新,应该滚动审查;
- 对齐应该保证模型在持续更新中自我监督,在跨用户的聚合/联邦学习中不变坏;
- 如今主流的 AI Mind 不超过五个,吃同一批数据,长得都一样;经验分化后,会涌现真正不同的模型,摆脱 mode collapse;
- 最好的模型用得最多、反馈最多、变得更聪明,飞轮转得更快;
- 由此,越强的模型越要早放出去,而不是藏着掖着;
- 换模型等于辞退一个攒了很久经验的老员工,切换成本奇高,一旦锁死之后利润可以随便要;
- 用户要么让自己的context锁在一家provider,要么放弃“越用越懂你”;大厂也会补贴那些愿意授权session的用户,拒绝授权的人就拿不到最好的模型;
- 个性化如果不在LoRA里,而是全量权重的分叉,那么单用户
batch size=1几乎只有大厂能做。
可见他心目中的持续学习或许还是“中心化分发”,而本文认为,持续学习的题中应有之义,是自然语言与参数的有机结合,并且无论以何种方式沉淀,这些经验应当属于用户。小扎在上个月说,《未来属于所有人》44,智能也应该属于所有人。
持续学习应该是一个三分法。写得出规则的,交给自然语言, 顺应的是人民群众对可控、可解释、可交接的需要;查得到的知识,交给外挂记忆, 参数里的每一比特都该省着花在规律上,死记的事实犯不着住进权重;剩下写不成规则、也查不成知识的那部分,交给参数, 这一路顺应的是事物发展的规律:基座在膨胀提速,个性化需求在爆炸,这两件事都不以任何人的意志为转移。世上没有两片相同的树叶,更不存在一个单一的超级模型能够cover一切需求,期待这样的一个AGI时刻,徒劳且荒谬。
科技专栏作者Steve Yegge一口咬定:Skills 是与Sutton“苦涩教训”的一场对赌,如果苦涩的教训照常应验,Skill里的知识迟早会被基模吃掉。但我们认为,不可能存在这样一个参数量无限大的基模,能装下所有人的不同的taste、“人味”、非标准、新奇感和宏观规划31。Skills是很好的解法,却也是有局限性的解法。
早在2024年初,UC 伯克利 BAIR 实验室就提出“从模型到复合 AI 系统”,最前沿的结果,越来越多出自多组件系统而非单体模型45;英伟达研究院去年的立场论文,也提出窄任务小模型和通用能力大模型的异构协作才是自然选择46;咨询公司Gartner的分析师Will Sommer上个月甚至说,地平线上没有一个模型,能对所有场景同时做到可靠又便宜,单条智能体工作流的推理成本到 2028 年还要涨5倍47。我们至少需要一些“满足自己需求的小模型”。
由此很容易想到模型的Personalization,其实是一个比较成熟的领域了。近两年的综述看下来,可分四派:(1) 画像:把用户历史压成画像与记忆,使用时检索进上下文48;(2) 推理:不动黑盒模型,在思维链层面把推理路径对齐到用户49;(3) 奖励:把评估者给定制化,训练每个用户自己的奖励模型,测试时还能按用户拓展50;(4) 参数:为每个用户微调一小片权重,是这里面最小的一支51。前两派是一个模型服务所有人,个性化全部得现场算,其实都是“租”,后两派是“买”。
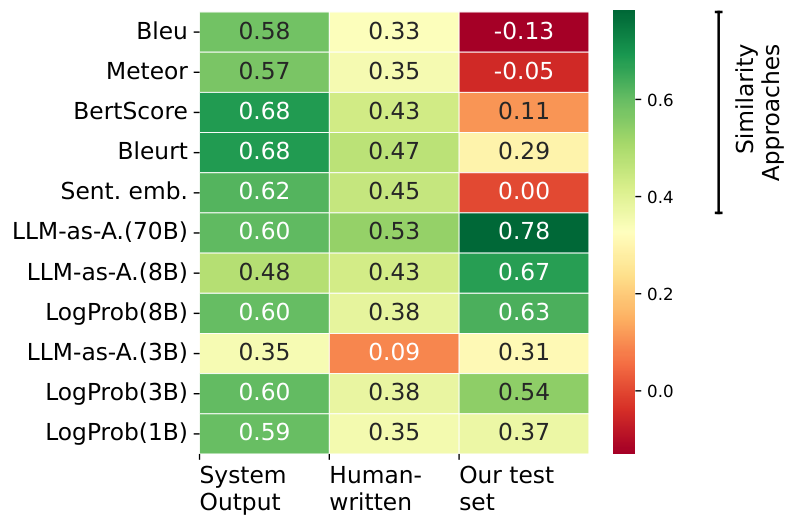
可能唯一难搞的一环是评估。 学习需要有信号,有指挥棒。个性化的结果几乎只有目标用户本人才能准确判断好坏52,自动评估指标又会在特定的数据构成下给出虚假的高相关53,而且还别忘了Goodhart’s Law,一旦找到一个金标准,模型就会reward hacking,检验起来更是灾难。
五、兵家必争
AI热潮很大程度上是“造词”的狂热,尤其是一种拟人化的造词,比如“神经元”“感知机”“注意力”“记忆”,给人一种机器崛起、赛博仿生的距离感54。笔者认为有必要将本文关注的“持续学习” 与一些时兴的热词做一些联系和区分,包括主权AI(Sovereign AI)、测试时训练(Test-Time Training, TTT) 和递归自我改进(Recursive Self-Improvement)。
主权AI
这个词最早2023年老黄就在兜售55,原本指的是国家层面的正儿八经的主权,往后几年也确实有零一万物和 哈萨克斯坦、面壁智能和老挝、MiniMax和沙特的落地结果56。但如今很多人在把这个概念往企业和个人上靠:基座终归不属于我们,所以为了业务安全,减小迭代适配成本,我们需要有自己能够掌控的AI,而不是任由基模厂商宰割使唤,而实现的路径有多种,其中一条或许是从头开始训练,真正拥有所有权重。
本文认同“智能属于每一个人”的类似“主权”的态度,但并不认为所有问题都能通过训自己的基座来解决。或许窄任务小模型行得通,但基座的通用能力在大模型重工业的今天极难复刻,不如直接站在巨人的肩膀上。
测试时训练(TTT)
这其实是本文最畏惧的一支,代表是Ilya Sutskever的SSI。传闻他们的TTT效果很好,已经在路上。SSI向来神秘,只能看见它与英伟达的长期合作、下一代平台算力,以及两年约80亿美金的融资57。
不过我们能够略微拼凑出TTT的技术线:让模型在推理的同时,就地做几步梯度更新,推理和学习变成同一个动作,其实在2020年就有雏形58;2024年被做进序列层内部,层的隐状态本身就是一个小模型,每读一段输入就把自己训一下,作为一种处理长上下文的解法59。Sutskever在领NeurIPS时间检验奖时说,互联网数据是化石燃料,预训练将毫无疑问地终结60;此后的零星表态里,他们暴露的方案大概是四块:TTT做进架构;模型在服务中持续更新,会话即训练流;学习信号靠内部的价值函数,不靠人工标注;scaling 从训练侧挪到推理时计算。核心的信念是:要完全消解掉训练和推理的边界。
首先,闭源的TTT如果能够跑通,模型能一边对话一边原地训练,任何外挂的参数都会被基座吃掉,那我们的方案,也可能反过来自己当一回苦涩的教训。所以落地的第一步,有评估,还应该有“外挂参数究竟能够承载什么特殊性”的justification,得从现实世界找找场景。或许写作/语言风格是一个起点。
其次,得看大厂能不能把“为每个用户托管一份个性化权重”的边际成本,压到推荐系统养用户画像的量级。能压,个性化就会成为基座的原生功能,含到订阅里,我们就真成了苦涩的教训;不能压,外挂参数才有活路。
用户画像很轻,但权重可很重,而且要持续训练、要驻留显存、要打断批处理。何况就算便宜下来,实验室的目标函数也是全体用户的均值,个性化和它天然相克,所以一顿强化只能提升通用能力,非通用的地方(比如语言风格,coding agent真的不说人话)就只能mode collapse。
别的厂商不清楚,但Mind Lab已经在推广了:MinT把模型训练做成了 API,SDK 里训练、采样、checkpoint、存储并列计费,叫training token61;目前推理已对个人开放、第三方网关都能查到价目62;托管训练则以企业邀请制接入为主,训练计价没有公开列价61。训练 token 的价格跌得越快,个性化权重就越接近“顺手吞掉”的区间。
递归自我改进(RSI)
RSI的前一个buzzword叫强化学习,在数学、代码、游戏里早就已经跑通了:R-Zero 让 Challenger 和 Solver 两个角色零数据互相出题、共同进化63。但要有信号才能转得起来,也就是“可验证奖励的强化学习”(RLVR, Reinforcement Learning with Verifiable Rewards),reward里一旦榨不出新信息,马上就会平台化64。
RSI会更加强调,在coding agent能力大幅提升的今天,AI可以写提升自己的代码和策略、构建提升自己的环境,如此这般。9月10日上海交大和Theseus Labs发了一篇来头很大的综述:《The Last AI Built by Humans》65,他们把RSI定义为“把经验与反馈变成持久化的改变,并且同时改进自身能力,也改进提升自身能力的过程本身”,然后根据AI有多少改进中的决策权,把RSI分成L1-L5。由此,这篇综述认为,如果经验积累只在于能力的提升,而学习目标、更新规则、验收测试这些仍交给人类,那就还只是持续学习;只有当AI开始决定怎么修改、怎么评价、怎么沉淀,且改过的流程还能被下一轮复用,才算是摸到RSI的门槛。
本文的主张:RSI不仅仅是一座数据中心里的巨型系统自己改进自己,也可以是每个用户身边的那一小片。换言之,持续学习可以是个体层面的 RSI。这条路走到头,让笔者想到Meta和KAUST今年4月的立场论文《Neural Computers》66:神经网络本身就可以是一台计算机,可以把计算、内存、IO全部内化到模型学到的隐式运行时状态里,不再依赖外部独立硬件软件模块做状态托管,未来最终形成一种稳定执行、可编程、能力持久复用的通用神经计算形态,从此每个人桌面上都有一个朝着你的方向不断进化的神经网络。期待这样一个未来。
混合架构的春天?
未来一定不是one size fits all。已经有不少跑出实际结果的例子来印证了。
今年7月,PyroDash:4B的Qwen3.5先做题,生成途中一旦发现自己handle不住,就吐出一个“举手”的token,系统随即将已有推理轨迹打包,交给冻结的 GLM-5.2-FP8 续写,单向,至多一次,何时求助的策略内化在小模型自己身上,不需要外挂路由器,不动大模型梯度,只要一个标准的文本补全接口67。“举手”这个token的训练,首先会初始化在句号、换行这类“自然断点”附近,再用EasyHard-24k数据集做监督冷启动,答对的算易,答错但能重构出正确轨迹的算难;最后上成本感知的强化学习,把成本写进奖励,并且通过一个旋钮控制模型“举手”的频次,如果调得比较合适,性能还反超冻结的大模型6.36个点,成本还便宜20%,因为大模型接手时看到的不仅有题面,还有小模型整理好的推理。
Pyromind创始人Kevin Ding最近在接受访谈时说68:
「我们这个世界上需要被 AI 解决的问题和场景,……已经是无穷无尽的了。新场景还在不断产生,场景本身也不是静态的。在这样的前提下,想用一个有限参数的模型去泛化掉无限的场景,至少在 Transformer 架构上,挑战太大。」
「基模其实越好,对 Worker Model 来说压力就越小。这套架构本身就是在基座模型之上打的一个补丁,基座演进对它是好事而不是威胁。……效果、成本和隐私很难简单靠调用更大的模型同时解决,有些任务适合直接调用基座模型,有些更适合在本地小模型上完成,还有一些需要两者协作。基座模型越强,反而会出现更多路由、协同和成本优化的强化学习需求。」
PyroDash至少在数学benchmark上能够证明其优势,本文也与其战略判断若合一契。但数学之外,“哪些更适合在本地小模型上完成”呢?在本文的讨论中,哪些是“一定要在本地的权重中承载”的呢?又如何评估呢?有待我们解答。
9月2日,mostik.ai 让模型之间直接交换隐状态,不再经由文本。发送端是 753B 的 GLM-5.2,只做读入;接收端是 4B 的 Qwen3.5,负责全部生成;中间一座单独训练的小桥(俄语的“mostik”),把大模型的表征空间翻译给小模型,两个模型全程冻结,只训练中间一个桥69。桥也不是即插即用,按他们的说法,两个模型的表征空间只有部分对齐、且对齐程度可预测,所以能训,但每对组合都得专门训一座桥。
4B 小模型接上桥,准确率能提升25%,难样本上翻倍;整对组合比同级中档模型省2.5倍算力,比文本transfer高10个点,交接点越早优势越大。启发有二。其一,连模型之间传文本都在丢信息,每个token只携带约2MB内部状态里的17个比特,所以把“个性化”写进权重几乎成为必然;其二,增量未必要和基座强绑定,它可以是用户手里的小模型加一座桥。Or does it have to be? 能否探索一种可以与大模型解耦的方法呢?这也有待我们解答。
混合不止小模型。9月10日,DeepSeek发布V4.1-Flash的技术报告,把分工设计进了单一模型的骨架:他们观察到Agent的workload里,频繁的工具调用带来海量prefill,读的量远大于写的量。于是Causal Encoder-Decoder架构让模型的前一半层充当“因果编码器”,专管读,后一半层做生成时,KV 直接从前半层的隐状态投影而来,prefill计算量近乎减半;落到激活参数上,读一个token激活 8B,写一个token激活 16B,读是简配,写是顶配。再叠加稀疏注意力与 FP4 缓存,全局 KV 压到每 token 890 字节,只有上一代的四分之一70。
你或许可说,任何混合的架构都会在将来被一个巨大的中心化的ASI取代,所以当下的这些解法,有如Skills,work得很好,但不够优雅,仍然有可能是苦涩的教训。但越靠近优雅,或许就越远离真相。
总结:Monticule方案
持续学习是工程问题、科学问题,还是社会问题,鲜有这样的领域让笔者产生如此大的兴趣。我们相信持续学习,尤其是个性、定制模型导向的持续学习的未来前景,由此想要创办一个Neo Lab,Monticule Tech,不断探索持续学习的可能性边界,并面向广泛、零散的真实世界任务,不断沉淀你的隐性偏好、审美、经验与判断,交付真切的社会价值,从而真正增进人类福祉。
综合下来,我们提出Monticule方案:
- 可以适应远端基座的不断进化,并且能够从基座进化中受益
- 与基座模型完全解耦,适应基座的家族更替,以及用户的自由选择
- 远端强基座 + 持续适应用户的小参数空间 + 持续沉淀的自然语言空间(包括知识与指令)
- 探索、论证并评估验证Monticule方案能够承载人类智能的哪些方面
我们并不打算预设一些技术路线,能够实现上述目标的技术组合均可成为Monticule方案。工程、科学、社会这三条线,最后都能支撑我们得到同一套判断:基座更迭,那就与基座解耦;LoRA无法产生新能力,那就选择拥抱强基座;自然语言的Skill和Memory装不下的,我们用参数空间补;以及越来越多证据支持,混合架构会是未来。一个最大的信念:我们不相信未来会有一个包揽一切的ASI,能够涵盖人类社会与人类智慧的一切复杂和多元,智能属于每一个人,个性不必受制于“租参数”。
这样的路线能够走通吗?能够成为下一个范式吗?是否将被一个更为通用、更加优雅的解法吞没,再一次成为苦涩的教训?
持续学习从来不是新鲜事,但在基座Agent模型的今天,眼下还没有一个厂商能够完全推出一个成熟落地的解决方案,它足够难,足够复杂,足够宽广,我们相信Monticule能够做出自己的贡献。
参考文献
Footnotes
-
Kirkpatrick, J., et al. Overcoming catastrophic forgetting in neural networks. PNAS, 2017, 114(13): 3521–3526. arXiv:1612.00796 ↩
-
Xu, Y., et al. ReLoRA: Knowledge-Reusing Adaptation for Fast Rollout of Evolving LLM Services. 2026. arXiv:2606.02606 ↩
-
Houlsby, N., et al. Parameter-Efficient Transfer Learning for NLP. ICML 2019. arXiv:1902.00751 ↩
-
Li, X. L., & Liang, P. Prefix-Tuning: Optimizing Continuous Prompts for Generation. ACL 2021. arXiv:2101.00190 ↩
-
Hu, E. J., et al. LoRA: Low-Rank Adaptation of Large Language Models. ICML 2022. arXiv:2106.09685 ↩ ↩2
-
Biderman, D., et al. LoRA Learns Less and Forgets Less. TMLR, 2024. arXiv:2405.09673 ↩
-
Zhang, C., Bengio, S., Hardt, M., Recht, B., & Vinyals, O. Understanding Deep Learning Requires Rethinking Generalization. ICLR 2017. arXiv:1611.03530 ↩
-
Barron, J., & White, D. Too Big to Think: Capacity, Memorization, and Generalization in Pre-Trained Transformers. ICML 2025 Workshop. arXiv:2506.09099 ↩
-
Allen-Zhu, Z., & Li, Y. Physics of Language Models: Part 3.3, Knowledge Capacity Scaling Laws. ICLR 2025. arXiv:2404.05405 ↩
-
Yang, L., et al. Looped Transformers are Better at Learning Learning Algorithms. 2023. arXiv:2311.12424 ↩
-
Huang, J., et al. Why Larger Models Learn More: Effects of Capacity, Interference, and Rare-Task Retention. 2026. arXiv:2605.29548 ↩
-
Cheng, X., et al. Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models. 2026. arXiv:2601.07372 ↩
-
Zou, A., et al. Representation Engineering: A Top-Down Approach to AI Transparency. 2023. arXiv:2310.01405 ↩
-
Yang, K., & Klein, D. FUDGE: Controlled Text Generation with Future Discriminators. NAACL 2021. arXiv:2104.05218 ↩
-
Huang, C., et al. LoraHub: Efficient Cross-Task Generalization via Dynamic LoRA Composition. COLM 2024. arXiv:2307.13269 ↩
-
Ilharco, G., et al. Editing Models with Task Arithmetic. ICLR 2023. arXiv:2212.04089 ↩
-
Wang, Z., et al. Why Do More Experts Fail? A Theoretical Analysis of Model Merging. ACL 2026. arXiv:2505.21226;aclanthology.org/2026.acl-long.2108 ↩
-
Yadav, P., Tam, D., Choshen, L., Raffel, C., & Bansal, M. TIES-Merging: Resolving Interference When Merging Models. NeurIPS 2023. arXiv:2306.01708 ↩
-
Sutton, R. The Bitter Lesson. 2019. incompleteideas.net/IncIdeas/BitterLesson.html ↩
-
Liu, Y., et al. Look Within or Look Beyond? A Theoretical Comparison Between Parameter-Efficient and Full Fine-Tuning. ACL 2026. arXiv:2505.22355;aclanthology.org/2026.acl-long.2208 ↩
-
Zindari, A., Mulayoff, R., & Stich, S. U. LoRA vs. Full Fine-Tuning: A Theoretical Perspective. 2026. arXiv:2605.19018 ↩
-
Zhang, B., Liu, Z., Cherry, C., & Firat, O. When Scaling Meets LLM Finetuning: The Effect of Data, Model and Finetuning Method. ICLR 2024. arXiv:2402.17193 ↩
-
Schulman, J., et al. LoRA Without Regret. Thinking Machines Lab, 2025. thinkingmachines.ai/blog/lora ↩
-
Shuttleworth, R., Andreas, J., Torralba, A., & Sharma, P. LoRA vs Full Fine-tuning: An Illusion of Equivalence. NeurIPS 2025. arXiv:2410.21228 ↩
-
Wu, X., Huang, S., & Wei, F. Mixture of LoRA Experts. ICLR 2024. arXiv:2404.13628 ↩
-
Mind Lab. On the Scaling of PEFT: Towards Million Personal Models of Trillion Parameters. 2026. arXiv:2606.02437 ↩ ↩2
-
Mind Lab. Macaron-V1: Towards Open Continual Learning with Self-Improvement and Mixture-of-LoRA. 2026. arXiv:2608.09819 ↩
-
Khan, R. M. S., et al. PortLLM: Personalizing Evolving Large Language Models with Training-Free and Portable Model Patches. ICLR 2025. arXiv:2410.10870 ↩
-
OpenAI Community. OpenAI is winding down the fine-tuning API and platform. community.openai.com ↩
-
O'Reilly, T. How We Bet Against the Bitter Lesson. O'Reilly Radar, 2026. oreilly.com/radar ↩ ↩2
-
翁家翌. Learning Beyond Gradients. trinkle23897.github.io/learning-beyond-gradients ↩
-
Zhou, J., et al. Instruction-Following Evaluation for Large Language Models (IFEval). 2023. arXiv:2311.07911 ↩
-
Elder, B., Duesterwald, E., & Muthusamy, V. Boosting Instruction Following at Scale. 2025. arXiv:2510.14842 ↩
-
Xiao, G., et al. Efficient Streaming Language Models with Attention Sinks (StreamingLLM). ICLR 2024. arXiv:2309.17453 ↩
-
Liu, N. F., et al. Lost in the Middle: How Language Models Use Long Contexts. TACL, 2024. arXiv:2307.03172 ↩
-
孙家正、牛嘉阳、李明轩. 提示词软件危机:Agentic AI 系统的工程化挑战. 安全内参, 2025. secrss.com/articles/85625 ↩
-
Deng, M., et al. RLPrompt: Optimizing Discrete Text Prompts with Reinforcement Learning. EMNLP 2022. arXiv:2205.12548 ↩
-
Anthropic. A Guide to the Anatomy of Effective Commerce Agents; Formalizing Fermat's Last Theorem(两篇合参). 2026. claude.com/blog; anthropic.com/research ↩
-
Dai, D., et al. Why Can GPT Learn In-Context? Language Models Implicitly Perform Gradient Descent as Meta-Optimizers. Findings of ACL 2023. arXiv:2212.10559 ↩
-
von Oswald, J., et al. Transformers Learn In-Context by Gradient Descent. ICML 2023. arXiv:2212.07677 ↩
-
Song, Y., et al. Do Implicit Personalization and Explicit Styles Conflict? (PsPLUG). 2026. arXiv:2601.06362 ↩
-
Patel, D. 8 Predictions for the Era of Continual Learning. Dwarkesh Podcast, 2026. dwarkesh.com/p/era-of-continual-learning ↩
-
Zuckerberg, M. The Future Is for Everyone. Meta, 2026-08. meta.com/thefutureisforeveryone ↩
-
Zaharia, M., et al. The Shift from Models to Compound AI Systems. BAIR Blog, 2024-02-18. bair.berkeley.edu ↩
-
Belcak, P., Heinrich, G., Diao, S., et al. Small Language Models are the Future of Agentic AI. NVIDIA Research, 2025. arXiv:2506.02153 ↩
-
Gartner Predicts AI Inference Costs Per Agentic Workflow Will Increase More Than Fivefold Through 2028. 2026-08-17. gartner.com ↩
-
Zhang, Y., et al. Evoking User Memory: Personalizing LLM via Recollection-Familiarity Adaptive Retrieval (RF-Mem). ICLR 2026. arXiv:2603.09250 ↩
-
Kim, J., et al. RPM: Reasoning-Level Personalization for Black-Box Large Language Models. ICLR 2026. arXiv:2505.21082; Wang, C., et al. Think-While-Generating: On-the-Fly Reasoning for Personalized Long-Form Generation. ICLR 2026. arXiv:2512.06690 ↩
-
Zhang, P., et al. P-GenRM: Personalized Generative Reward Model with Test-time User-based Scaling. ICLR 2026. arXiv:2602.12116;同派工作见 Singh, Hsu, et al. FSPO: Few-Shot Optimization of Synthetic Preferences Effectively Personalizes to Real Users. ICLR 2026 ↩
-
Liu, J., et al. A Survey of Personalized Large Language Models: Progress and Future Directions (PLLM). 2025. arXiv:2502.11528 ↩
-
Xu, Y., et al. Personalized Generation In Large Model Era: A Survey. ACL 2025. arXiv:2503.02614 ↩
-
Pauli, A. B., Augenstein, I., & Assent, I. Mind the Style Gap: Meta-Evaluation of Style and Attribute Transfer Metrics. Findings of EMNLP 2025. arXiv:2502.15022 ↩
-
Mitchell, M. Why AI Is Harder Than We Think. 2021. arXiv:2104.12871 ↩
-
Financial Times, How Nvidia's Jensen Huang became AI's global salesman. 2025. ft.com; epoch.ai; The Economist, Meet Nvidia's lucrative new customers. 转载 ↩
-
零一万物×哈萨克斯坦:新华网《从上海到阿斯塔纳》2026-07-20 news.cn; 面壁智能×老挝:新浪科技 2026-06-04 finance.sina.com.cn; MiniMax×沙特:新浪财经《大模型出海有新模式》2026-09-05 finance.sina.com.cn ↩
-
NVIDIA. Ilya Sutskever's Safe Superintelligence Inc. and NVIDIA announce long-term strategic partnership. 2026. nvidianews.nvidia.com; en.globes.co.il ↩
-
Sun, Y., Wang, X., Liu, Z., Miller, J., Efros, A. A., & Hardt, M. Test-Time Training with Self-Supervision for Generalization under Distribution Shifts. ICML 2020. arXiv:1909.13231 ↩
-
Sun, Y., Li, X., Dalal, K., et al. Learning to (Learn at Test Time): RNNs with Expressive Hidden States. 2024. arXiv:2407.04620 ↩
-
The Verge. OpenAI cofounder Ilya Sutskever predicts the end of AI pre-training. 2024. theverge.com ↩
-
Mind Lab. MinT Documentation. 2026. mint-doc.macaron.im/sdk/api-reference/types ↩ ↩2
-
Opper. Macaron-V1-Venti Pricing. 2026. opper.ai/mind-lab ↩
-
Huang, C., et al. R-Zero: Self-Evolving Reasoning LLM from Zero Data. 2025. arXiv:2508.05004 ↩
-
Liu, W., Qi, S., Du, Y., & He, Y. Self-Play Only Evolves When Self-Synthetic Pipeline Ensures Learnable Information Gain. ICML 2026 position track. arXiv:2603.02218 ↩
-
Duan, Y., et al. The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement. 2026. arXiv:2609.11873 ↩
-
Zhuge, M., et al. Neural Computers. Meta AI & KAUST position paper, 2026. arXiv:2604.06425 ↩
-
Lyu, N., Shi, P., Qiu, W., et al. PyroDash: Cost-Efficient Token-Level Small-Large Language Model Collaborative Inference. 2026. arXiv:2607.20327 ↩
-
Kevin Ding 观点出自其播客访谈,转引自机器之心微信公众号报道《左手推理成本暴降 96%,右手性能反超大模型!当小模型学会了何时求助》,2026-09;项目页 Pyromind-Dynamics.github.io/PyroDash ↩
-
mostik.ai. 2026. mostik.ai/read-more ↩
-
DeepSeek-AI. DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression. 2026. huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash ↩